Debug-Lab
嵌入式视角下的 AI 辅助编程入门指南
面向初学者,介绍语言模型与 Agent 的工作方式,以及嵌入式开发中的需求定义、上下文管理、Git 协作、代码审查与测试。
嵌入式视角下的 AI 辅助编程入门指南
代码生成以后,还有哪些工作
OJ 上的 C 程序通常通过 scanf 读入数据,完成计算,再用 printf 输出结果。例如,读入若干个成绩,输出平均分。题面已经规定了输入格式、数据范围和小数位数,评测系统负责检查结果。提交后得到 AC,这道题就完成了。
把同样的计算做成一个供他人使用的成绩查询工具,需要决定的事情就多了。成绩从哪里导入,同名学生怎样区分,文件出错时怎样处理,原来的数据能否继续使用,都没有现成的题面。程序投入使用后,还会增加功能、修复 Bug,并交给其他成员维护。
Agent 已经能够承担其中不少工作。给出要求后,它可以阅读文件、编写函数、运行程序,并根据报错继续修改。原本需要逐句敲出的代码,现在可能很快就出现在编辑器里。
但生成速度提高以后,项目并没有自动完成。查询功能能够运行,却只返回第一条同名记录;保存功能没有报错,却改变了旧文件格式;为一个小功能增加了许多配置,下一次修改反而更费力。这些问题都发生在代码已经生成之后。
因此,软件开发的工作量不能只按代码量理解。确认真正的需求、选择合适的方案、检查修改带来的影响,都需要投入时间。Agent 可以参与这些工作,开发者也需要有能力判断它提出的建议。
软件工程讨论的正是这些事情。Agent 降低了实现的门槛,也让开发者更早面对一个完整项目的设计、协作与交付。理解这种工作方式,需要先看清模型提供了什么能力,以及这些能力怎样通过工具进入开发过程。
模型提供了什么能力
聊天窗口中的解释、代码和工具调用,通常由语言模型生成。LM 是 Language Model,即语言模型;LLM 是规模较大的语言模型。常见的生成式语言模型会根据已有内容,逐步预测并生成后续文本。
文本怎样进入模型
模型处理一段文本时,会先把它切成一个个小片段,每个片段叫作一个 Token。完成这项切分工作的程序叫 tokenizer,通常译作“分词器”。Tokenization 就是把文本切分成 Token 的过程,也可以理解为“Token 化”。
例如,假设把“李四的成绩是92。”切成“李四”“的”“成绩”“是”“92”“。”六个片段,那么每个片段就是一个 Token,这段文本便有六个 Token。这是一种示意切法,实际怎样切,由所用的 tokenizer 决定。
因此,一个 Token 不一定是一个字,也不一定是一个完整单词。一个较长的英文单词可能被拆成几部分,标点和空格也可能单独成片段,或与相邻文字放在一起。看到“输入用了多少 Token”时,可以理解为输入文本经过切分后有多少个这样的单位。
分词器还会把片段对应到词表中的数字编号,称为 Token ID。可以把词表理解为一张“片段与编号”的对照表:编号用来识别片段,后面的 Embedding 才会为它取得向量表示。因此,Token 化与向量化是前后相接的两个步骤。同一段文字换用不同的分词器,切法和 Token 数都可能变化,不能用固定的字数比例精确换算。
切分以后,还要把这些文字片段变成模型能参与计算的数字。Embedding 做的就是这一步向量化:用一组数字表示一个 Token。例如,一个教学用的表示可以是 [0.2, -0.5, 0.8]。这组按顺序排列的数字就叫作向量,可以先把它理解成一个存放小数的数组。
这样,人能够阅读的自然语言,就转换成了机器能够计算的数字。每组数字可以看作抽象空间中的一个位置,这个空间称为向量空间。Embedding 为文字建立了这样的数值表示,后续处理便可以通过数字运算进行。
这些向量随后进入 Transformer,这是 2017 年的论文《Attention Is All You Need》提出的一种计算结构,后来被许多语言模型采用。模型内部有大量训练得到的参数,它们记录了训练中学到的规律。输入向量按照这些参数经过一层又一层计算,不断得到新的表示。
计算过程中,文本各部分的信息也会联系起来。例如,回答“李四的数学成绩是多少”,需要结合问题中的姓名和成绩表里的对应记录。注意力机制就参与这种信息联系,让一个位置的表示能够结合其他位置的内容。
经过多层变换,模型最终为可能接在后面的各个 Token 算出概率。生成程序据此选出一个 Token,接到已有内容后面,再重复这个过程,继续预测下一个。
模型生成回答时,也是这样逐个生成 Token,最后将它们还原为可阅读的文本。输入和输出都以 Token 为处理单位,所以模型的上下文容量、生成长度和 API 用量常用 Token 数表示。
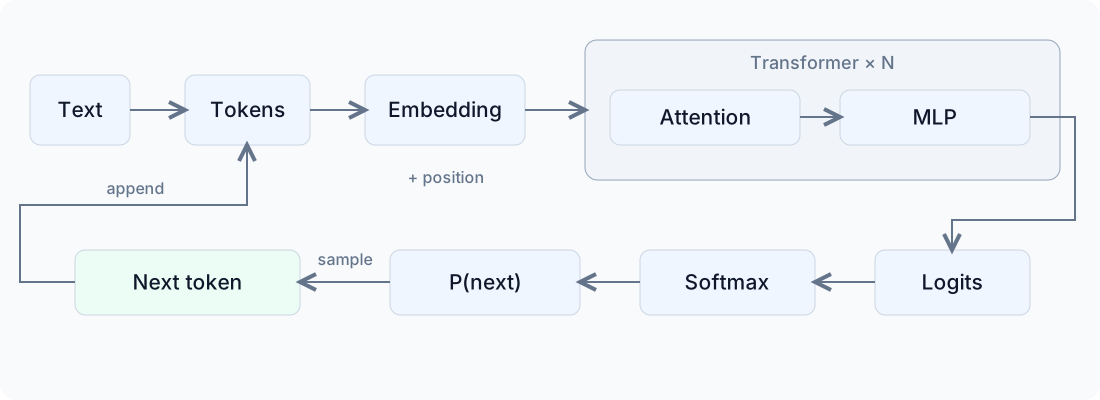
已有内容会影响后续生成,这些可参考的信息称为上下文。补入项目源码、报错或明确的要求,会改变模型作出判断的依据。上下文窗口有容量限制,应用需要决定哪些内容在这次调用中提供。
模型怎样学会预测
模型刚开始并不知道一句话应该怎样接下去。前面提到的参数,就是模型计算中使用的大量数值。训练所做的事情,是反复调整这些数值,让预测结果逐渐接近训练文本中实际出现的内容。
例如,训练材料中有一句“李四的数学成绩是92”。把它切成 Token 后,假设“92”恰好是其中一个 Token,就可以把前面的内容交给模型,让它预测这个位置应该接什么,再用实际出现的“92”检查预测。
如果模型给“92”的概率很低,训练程序就会计算这次预测的误差,并据此调整参数。经过调整,模型在类似情况下就有机会给正确的后续内容更高的概率。大量文本中的许多位置都可以这样用于训练,答案直接来自原文。
一次练习只能提供很有限的信息。换上大量不同的文本,反复预测、比较和调整,模型才会逐渐学到常见的表达方式,以及文字之间更复杂的联系。这种先在大量材料上学习基础能力的过程,称为预训练。
为什么预测也能帮助模型写代码
预测下一段内容,有时只需要熟悉表达习惯,有时却需要结合整段材料。句子前面写了某人的姓名和成绩,后面回答成绩问题时,就需要利用这条信息。
代码也是如此。一段程序声明了变量,后续代码就可能继续使用它;函数要求求平均分,后面通常需要求和、计数和除法。为了更准确地预测这些代码,模型需要学到变量使用、程序结构和计算步骤之间的关系。
训练材料还可以包含问题与解答、翻译、说明文档等内容。它们的用途不同,却都可以写成一段接一段的文本。因此,同一个预测任务,可以让模型接触并学习多种任务中的规律。
2018 年提出的初代 GPT 推动了这种生成式预训练路线的发展:先让模型广泛学习文本,再把得到的能力用于具体任务。这里体现了一种 “Less is more” 的思路——不必为每一种用途分别设计一套完全独立的学习任务,一个统一的目标也能支撑多种能力。2018 年的 GPT 论文介绍了这种做法。
为什么要强调“大”模型
语言模型既然是在预测下一个 Token,为什么还要把它做得这么大?因为同一个预测任务,可能需要用到非常不同的知识:补全一句日常对话、解释一段程序、理解一份技术文档,对模型提出的要求并不相同。要让一个模型处理广泛的材料,就需要足够的能力去学习其中的规律。“大”首先强调的,就是模型的参数规模。
学习效果还取决于模型有多大、接触了多少材料,以及进行了多少训练。参数更多,意味着模型可以用更多可调整的数值表达学到的规律;数据更多,意味着有机会接触更丰富的内容;训练这些参数和数据,则需要相应的计算量。
Kaplan 等人在 2020 年的研究中发现,在一定条件下,合理增加这些投入,模型预测文本的误差会呈现较为规律的下降。这类规模与效果之间的经验关系,称为 Scaling Law,也就是缩放定律。它帮助研究者估计继续扩大训练可能带来的收益。2020 年的 Scaling Laws 论文给出了实验依据。
不过,语言模型并不一定要做得很大。任务范围较窄,或者设备的内存、算力有限时,较小的模型也有用途。强调“大”,是因为扩大规模推动了通用能力的发展,并不意味着只看参数数量就能判断效果。模型规模、数据和计算投入还需要配合。DeepMind 在 2022 年发表的 Chinchilla 研究就展示了:在相近的计算预算下,较小的模型配合更多训练数据,也能胜过更大的模型。
随着训练规模扩大,一些原本完成得很差的任务可能逐渐变得可用。例如,模型开始能够根据输入中的几个示例,继续完成同类任务,而不必专门为这次任务重新训练。2020 年的 GPT-3 研究展示了这样的表现。这类新能力的出现常被称为“涌现”,具体效果仍需要通过任务测试判断。
后训练:模型怎样学会按人的要求回答
预测文本的能力提高以后,还有一个问题:自然地续写一段文字,与按要求提供帮助,并不是同一个训练目标。例如,输入“请解释这段 C 程序”,接下来既可能是一份解释,也可能是另一道相似的题目。预训练材料中存在各种写法,模型需要进一步学习此时应该采用哪一种。
这就是后训练要处理的问题之一。后训练是在预训练基础上继续调整模型,让它更适合具体用途。对于对话助手,调整的内容包括遵循指令、组织答案,以及采用合适的语言风格。要求简短说明时是否直截了当,要求详细讲解时是否把步骤展开,都影响实际使用体验。
人类可以通过示范和评价参与这个过程,这种做法称为 Human in the Loop,即让人参与反馈循环。后训练的范围更广,人类反馈是其中一条重要路线;早期 GPT 也并非都采用了这套训练方法。
以 2022 年的 InstructGPT 为例,训练先收集人写出的示范答案,让模型学习怎样回应指令,这一步称为监督微调(SFT)。随后,对同一个问题生成几份回答,由标注人员比较哪份更符合要求。比较结果用于训练一个奖励模型,让它学着预测人更偏好哪种回答,再用这个评价信号继续调整语言模型。这就是基于人类反馈的强化学习,简称 RLHF。
效果可以通过回答比较来检验。2022 年的 InstructGPT 论文使用来自 API 用户的提示进行评测,让标注人员判断更偏好哪一份回答。实验中,经过这种训练的 13 亿参数 InstructGPT,其回答甚至比 1750 亿参数 GPT-3 更受偏好。这个结果说明,模型是否好用,除了规模,还取决于它能否把已有能力用于人的实际要求。偏好评测衡量的是这些任务中的回答表现,不代表小模型在所有能力上都超过了大模型。
2022 年 11 月发布的 ChatGPT也采用了人类反馈训练,并通过连续对话的界面,让解释代码、追问细节和修改要求更容易进入日常使用。
预训练、后训练与使用时提供上下文,也由此可以区分开来。前两者都涉及训练模型;把成绩表或项目代码放进对话,改变的是本次回答的依据,通常不会更新模型参数。Agent 既需要模型具备基础能力、能够遵循要求,也需要在工作时取得正确的项目资料。
进一步学习大模型原理,推荐观看《大模型进化论》视频系列。讲解通俗,思路连贯,可以结合大模型的发展过程理解相关技术。
Agent 怎样把回答变成行动
语言模型能够生成代码,但要把代码写进文件、启动编译器,还需要外部程序执行。2021 年推出技术预览的 GitHub Copilot,已经把早期 Codex 模型的代码建议接进编辑器。到 2023 年,Cursor 的早期版本把模型对话融入编辑环境;2024 年 11 月的 Cursor 0.43又加入了能够选择上下文、使用终端的早期 Agent。
2025 年 4 月推出的 Codex CLI和同年 5 月推出的云端 Codex Agent,把读取仓库、修改文件和运行命令组织成任务流程。这里的 Codex 是编程工具,2021 年同名的 Codex 则是代码模型。2026 年 2 月发布的 Codex 桌面应用又提供了管理任务和审查修改的界面。
这些工具把模型与文件、终端、浏览器等执行能力连接起来,让生成结果能够参与实际工作。要理解其中的分工,可以先看应用怎样调用模型。
API 连接应用与模型
API 是应用程序编程接口,规定程序可以请求什么功能、需要提供哪些参数,以及怎样取得结果。C 标准库中的 strlen(text) 就有明确的调用约定。模型厂商的网络 API 也有类似作用,只是计算发生在服务器上。
应用把输入整理为双方约定的数据格式,通常是 JSON。JSON 用字段名与对应的值组织数据,例如用一个字段保存消息内容。应用再通过 HTTP——一种网络请求协议——将这些数据发送给服务端。
请求中还需要指定模型,API Key 则用于验证调用身份。服务器收到请求后运行模型,将生成结果返回应用。这个过程把本地的输入界面与远端的模型计算连接起来。
例如,一条消息可以表示为:
{
  "role": "user",
  "content": "查找成绩查询函数,解释同名记录的处理方式。"
}
JSON 中的字段名说明数据用途。role 表示消息来源,content 保存内容。应用还需要按具体 API 的要求提供模型、地址等信息。千问 API 文档给出了完整的请求示例。
厂商主要提供模型推理等服务;本地 Agent 应用负责组织任务上下文,并管理本地工具。也有厂商托管的搜索和代码执行工具,模型也可以部署在本地。具体分工取决于工具在哪里运行。
Tool Calling 与 Agent Loop
为了读取源码,应用可以提供一个名为 read_file 的工具,说明它需要一个文件路径。模型生成调用请求后,应用解析名称和参数,检查操作范围,打开文件,再把内容返回给模型。
{
  "name": "read_file",
  "arguments": { "path": "src/query.c" }
}
这个过程称为 Tool Calling。模型写出“已经读取文件”不会触发文件操作,实际读取需要由工具完成。同样,声称“测试通过”和真正运行测试,是两件不同的事。
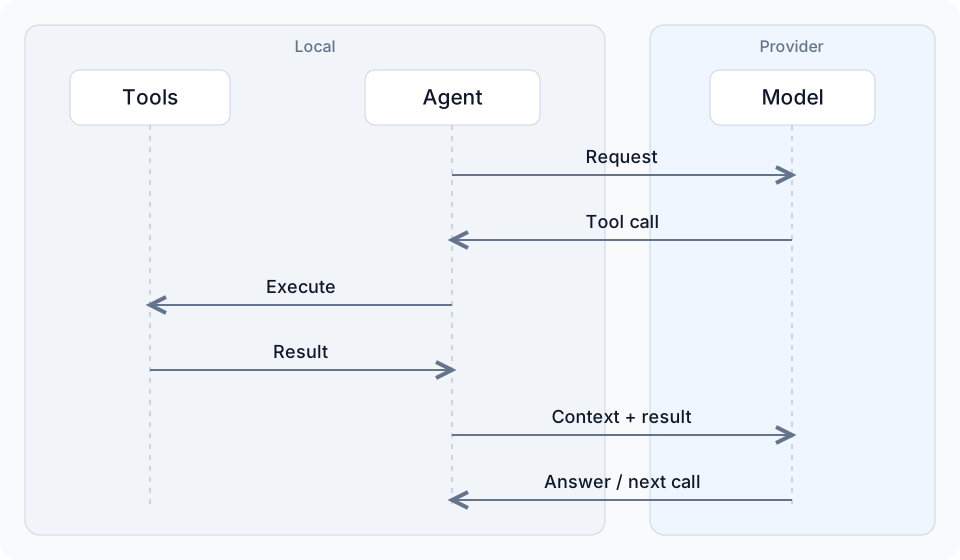
修复同名查询时,Agent 可以先搜索入口,读取相关函数,修改提前返回的逻辑,再运行测试。如果测试失败,报错会加入上下文,模型据此继续判断。不断调用工具、取得结果和调整行动,构成了 Agent Loop。
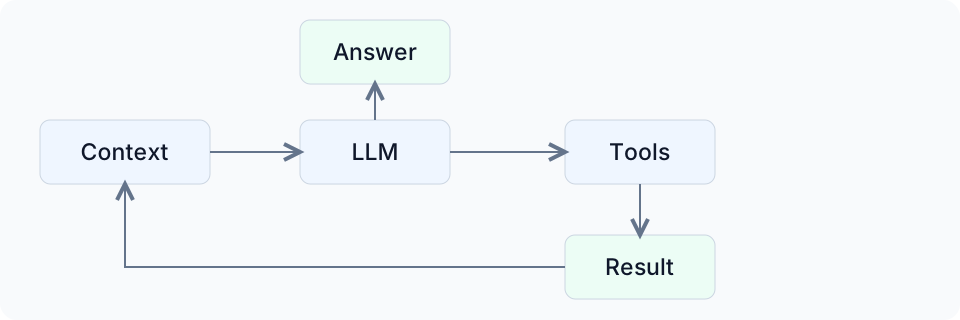
围绕模型管理上下文、工具、权限和循环的系统,通常称为 Harness。同一个模型使用不同的工具和背景信息,完成任务的表现也可能不同。界面采用命令行还是图形窗口,并不能单独决定协作质量。
Pi 提供了一个可以对照阅读的开源实现:模型接口负责连接不同服务,Agent 核心负责工具执行与循环,编码工具再把这些能力与会话和界面组合起来。其作者 Mario Zechner 在 2025 年 11 月的文章 What I learned building an opinionated and minimal coding agent 中解释了这些设计取舍。他关注的是能否看清并控制模型实际收到的内容,以及工具是否符合自己的工作方式。这也说明,理解 Agent 不能只看它使用哪个模型,还需要看 Harness 怎样组织工作。
Pi 的 Agent 核心文档把消息处理过程写得很直接:先整理上下文,再转换成模型接口接受的消息,随后调用模型;如果模型请求工具,就执行工具、记录结果并继续下一轮。因此,界面中的会话记录与实际送入模型的内容,并不必然完全相同。后面讨论上下文管理时,需要关注的正是这层组织过程。
Skill 则可以保存某类工作的说明、步骤和配套资源,供 Agent 在需要时使用。例如,一套固定的发布检查可以整理成 Skill。它仍然需要与项目实际情况一致,安装更多 Skill 并不会自动改善工作流。
多模态与 Computer Use
多模态模型可以处理文本以外的信息。图像通过视觉编码器转成数值表示,与文本一起参与计算。千问的 Qwen2.5-VL面向视觉与语言任务;Qwen2.5-Omni还支持音频等输入及语音输出。
有了视觉输入,Agent 可以通过截图观察软件界面,再调用点击、输入和滚动工具,取得新的截图继续判断。这就是 Computer Use 的一种实现方式。
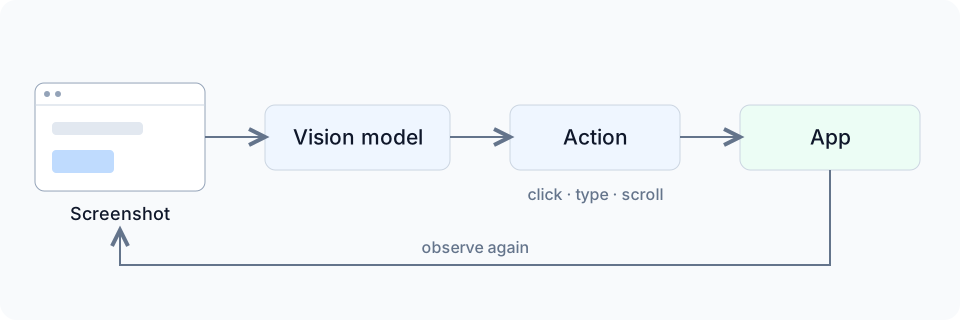
例如,检查成绩查询页面时,Agent 可以输入姓名、点击查询,并观察返回的记录。点击动作成功,不代表结果正确,仍然需要检查页面内容。已有稳定 API 或命令行工具时,也可以直接调用,不必所有操作都经过屏幕。
模型能力会持续进步,工具接口也会更新。目标是否明确、背景是否充分、结果是否得到验证,则始终影响一次任务能否完成。
上下文、生成速度与缓存成本
Agent 修复一个问题时,会反复读取代码、调用模型、执行工具。随着任务继续,对话越来越长,界面可能显示上下文占用、Token 用量、生成速率,或者提示正在压缩上下文。这些数字分别描述不同的事情。把一次任务的执行过程拆开,就能理解它们为什么变化,以及变化会影响什么。
上下文:模型这一次依据什么工作
上下文是模型在本次生成中可以参考的材料。对于 Coding Agent,它通常包含任务要求、项目规则、保留的对话、工具说明,以及已经读取的源码和工具返回结果。模型依据这些内容决定接下来怎样回答、读取哪个文件或执行什么命令。上下文窗口文档列出了这些组成部分。
例如,要求 Agent 排查设备通信故障,最初输入中可能只有故障描述。Agent 读取驱动后,驱动源码进入上下文;取得串口日志后,日志也进入上下文。后续判断便能同时参考问题、实现和实际现象。如果原理图仍然只保存在磁盘上,没有被读取或作为输入提供,它就还没有成为这次判断的依据。
所以,“文件在项目里”“文件曾在某次对话里出现”和“文件内容现在仍在模型的上下文中”,需要分别理解。聊天界面可以保存完整记录,Harness 却可能只选择其中一部分发送给模型。界面里仍能翻到一条消息,并不能保证模型当前也能逐字参考它。
模型训练得到的知识、当前上下文和外部保存的资料也有不同作用。训练形成了模型的一般能力;上下文提供当前任务的具体情况;磁盘文件、Issue 和历史记录则可以在需要时重新读取。所谓 Agent 的记忆功能,也需要通过检索、加载等方式,把有关信息带入当前工作过程。
Agent 怎样组织一次模型请求
模型并不是直接读取聊天界面上的所有内容。每次调用前,Agent 的 Harness 要收集当前任务、保留的历史、项目规则和可用工具,决定哪些资料需要加载,再把它们整理成请求。这个组织过程决定了模型这一轮能看到什么,也决定了需要处理多少输入 Token。
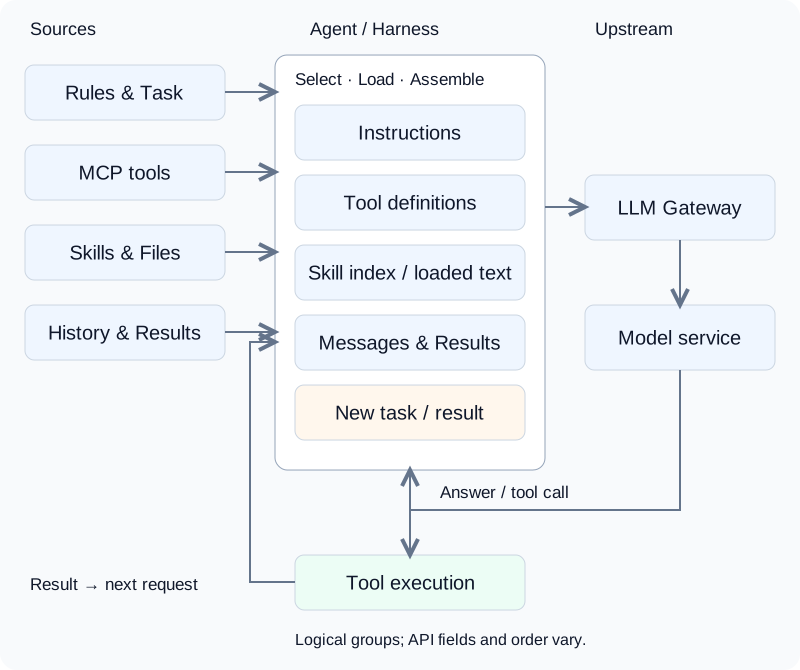
图中间是一次请求的逻辑组成。最前面的 Instructions 放置系统要求和开发者指令;项目规则也可能被注入指令或消息中。Tool definitions 描述可用工具的名称、用途和参数格式。Messages 则保存用户要求、模型先前的回答、工具调用记录和工具结果。新问题或刚取得的结果通常继续追加到消息历史中。不同 API 对这些内容使用的字段和排列方式有所不同,最终还会由模型服务转换成模型实际处理的输入序列。
例如,串口故障排查任务的规则可以要求“保留现有通信协议”;工具定义可以告诉模型,read_file 接收文件路径,run_command 接收要执行的命令。真正读出的驱动代码、编译错误和串口日志,则属于工具结果。工具定义说明能够做什么,工具结果说明已经取得了什么,两者都可能占用上下文。
MCP(Model Context Protocol,模型上下文协议)连接的是 Agent 应用与外部能力。Agent 可以通过 MCP 获取某个服务公开的工具列表,再将选中的工具定义转换成上游模型 API 接受的格式。模型请求调用工具后,Agent 才把调用交给对应的 MCP 服务,并整理返回结果供下一轮使用。MCP 工具规范分别定义了工具发现与调用。
因此,上下文里通常出现的是 MCP 提供的工具说明和返回内容,而不是一整台 MCP Server。连接地址、认证信息和连接管理由宿主应用处理;工具的实现代码也不必因为开放了工具,就全部发给模型。启用很多 MCP 服务,可能因为引入大量工具定义而增加输入,也可能由 Agent 的工具搜索机制按需加载,取决于具体实现。
Skill 的位置又有所不同。Agent Skills 规范采用渐进加载的思路:先提供名称、简介等元数据,使 Agent 知道有哪些 Skill;决定使用后,再加载 SKILL.md 的正文,必要时继续读取配套资料。图中的 Skill index 是索引,loaded text 是已加载内容。索引可能放在初始指令中,读取出的正文则可能作为工具结果进入消息历史,部分 Harness 也会将它注入指令。Skill 没有一个所有模型 API 都通用的专属消息角色。
这意味着,安装一个 Skill,不等于每次都把它的所有文件放进上下文。脚本在本地执行时,模型也不一定需要读完整份源码;执行结果被返回并保留后,才成为后续判断的材料。真正影响窗口占用的是本次请求加载了什么。
整理好的请求随后发到上游入口。在采用 LLM Gateway 的系统中,Gateway 是统一接收模型请求的网关,可以负责认证、模型路由和请求格式转换,再交给模型服务。有的应用直接调用厂商接口,没有独立网关。上下文由 Harness 组织,Gateway 可能继续转换或补充请求,而输入处理和 KV Cache 的复用通常发生在模型推理服务中。经过网关不代表一定命中缓存;转到不同模型或缓存不共享的服务实例,也可能无法继续复用。
模型返回回答或工具调用请求后,Agent 更新任务历史,执行需要的工具,再组织下一轮输入。于是,一段内容会经历“外部资料、加载进请求、保留为历史、被压缩或移除”的过程。上下文的结构是在这个循环里维护出来的。
上下文窗口:一次能容纳多少内容
上下文窗口是一次模型调用所能容纳的 Token 容量。它限制的是当次计算使用的内容,不是整个账号能保存多少聊天记录。常见模型的窗口由输入和本次生成共同使用,推理模型还可能生成不直接展示的推理 Token;这些 Token 同样需要占用相应预算。最大输出长度又是单独的限制,不能把窗口大小直接当成一次回答的长度。OpenAI 的上下文说明解释了这两类限制。
假设一个模型的窗口为 128,000 Token,当前输入已经占了 100,000 Token,那么窗口中只剩下约 28,000 Token 的余量。即使模型允许更长输出,这次调用也不能无视剩余空间。实际 Agent 通常还会为后续生成和工具结果留出余量,所以界面的可用容量可能小于模型标称容量。
窗口里的内容也远不止手动输入的几句话。一次读取长日志、一次返回大量搜索结果,都可能明显增加占用。若某轮生成了 2,000 Token 的解释,这段解释在下一轮被保留时,又成为下一轮的输入。Agent 连续工作时,历史消息、工具调用和结果便会逐步累积。
“窗口占用”与“累计用量”因此也不同。前者描述当前装了多少内容,后者统计多次调用一共处理了多少。假设连续三次调用的输入分别为 10,000、12,000、15,000 Token,累计输入就是 37,000 Token,即使最后一次窗口里只有 15,000 Token。重复使用的历史可能命中缓存,但仍然需要按对应的计费类别统计。
较大的窗口能容纳更多资料,却不意味着资料越多越好。两份互相冲突的接口说明,即使都放得下,仍然会造成判断困难。窗口解决容量问题,材料的相关性和可靠性则属于上下文工程。
Token 速率:等待发生在哪一步
界面中的 tokens/s 或 tok/s 表示每秒处理或生成多少个 Token。讨论回答“出字快不快”时,通常指输出生成速率。例如,按平均每秒 50 Token 估算,生成 1,000 Token 大约需要 20 秒。这里的单位仍然是 Token,不能理解为每秒 50 个汉字。不同产品也可能采用不同的计时范围,需要看指标定义。
一次请求大致包含两段模型计算。首先处理已有输入,这一阶段通常称为 Prefill;随后逐步生成新 Token,称为 Decode。输入处理可以利用批量计算,而后续生成依赖已经生成的内容,因此输入处理速度与输出生成速度不能当成同一个指标比较。
这也解释了为什么模型有时等待很久才开始显示文字,开始以后却输出得很快。请求可能经历网络传输、排队、输入处理,以及输出可见回答之前的推理。请求发出后到收到首个 Token 的时间称为 TTFT,即 Time to First Token;如果界面隐藏了中间推理,用户看见第一段正文的时间还可能更晚。
Agent 的总耗时又比一次回答更长。读取文件、编译、烧录、等待设备返回结果,都不属于模型的输出生成时间。一个任务可能包含多次模型调用和多次工具执行,所以输出速率翻倍,不代表任务耗时也能减半。延迟优化文档也将生成速度、请求次数与工具流程分开讨论。
API 控制台中的 TPM 则常用于表示每分钟允许处理的 Token 配额。达到这种速率限制后,请求可能需要等待或重试。它表示服务允许使用多少吞吐量,不等于单次回答能以多快的速度生成。比较模型时,首个结果的等待时间、输出速率和实际任务完成时间,都有各自的意义。
上下文压缩:任务怎样继续
任务持续进行,窗口迟早可能接近上限。继续保留全部历史,就没有足够空间容纳后续工作。上下文压缩,也常称为 Compaction,就是用更少的 Token 保留后续任务需要的状态,再以整理后的上下文继续调用模型。
一种容易理解的做法,是把较早的讨论整理成摘要。例如,排查通信故障时,前面可能记录了多次失败尝试、大段日志和重复读出的源码。后续真正需要的,可能是已经确认的接线、故障复现条件、排除过的原因、当前修改,以及尚未完成的验证。保留这些信息,就不必每次都携带全部排查过程。
具体产品不一定只生成一段普通文字摘要。某些服务会返回模型可以继续使用、但人无法直接阅读的压缩状态。例如 OpenAI 的 Compaction 接口可以返回这样的状态项。无论采用什么表示,目的都是减少当前占用,让长任务继续推进。
这种压缩不能按 ZIP 文件的无损还原来理解。摘要可能省略细节,原来的讨论也未必能够逐字恢复。例如,只留下“驱动已修改”,却漏掉“新版本尚未上板验证”,下一阶段就可能误判工作进度。压缩之后是否仍然准确,取决于关键要求、已知事实和未完成事项是否被保留下来。
被压缩掉的源码仍然可以从文件重新读取,但已经没有记录的设计理由未必能够靠代码还原。这也是把重要讨论留在 Issue、PR 等可追溯载体中的价值:上下文可以整理,工程依据仍有出处。
压缩本身也需要时间;如果通过额外模型调用完成,还可能产生相应用量。它用一次整理换取后续更小的上下文。是否值得,取决于整理成本、接下来还要工作多久,以及是否会丢失重要信息。
KV Cache:已经计算过的内容怎样复用
模型逐个生成 Token 时,后一个 Token 仍然需要参考前面的内容。生成第 100 个 Token 时处理过的历史,在生成第 101 个时大部分还会用到。如果每一步都重新计算这些历史表示,就会重复做很多工作。
KV Cache 保存了注意力层中,已经处理过的 Token 所对应的部分中间计算结果。KV 是 Key 和 Value 的缩写。生成后续 Token 时,可以复用这些结果,再处理新增加的部分。它缓存的是计算状态,不是事先保存好一整段答案。Hugging Face 的说明展示了这个复用过程。
因此,缓存命中不意味着直接复制上次回答。新问题仍然参与计算,新的输出仍然需要生成。缓存节省的是重复处理已有内容的一部分工作。
这也有资源成本。缓存需要占用存储空间,典型的完整注意力模型中,序列越长,需要保存的状态通常越多。服务器不可能无限保存每段对话的所有计算状态,因此还需要管理缓存的容量、位置和保留时间。
Prompt Cache:多次调用怎样少做重复计算
KV Cache 首先解释了一次生成中的复用。如果服务端进一步保留这些状态,下一次请求又带来了相同的开头,就有机会跨请求复用。模型 API 提供的 Prompt Caching,即提示词缓存,常利用这种方式减少重复输入的处理成本。
具体复用的是输入前缀经过模型计算后形成的状态,通常包括各层注意力的 Key、Value。原始文本仍然作为请求的一部分参与当前任务;服务端找到可用状态后,省去一部分 Prefill 计算,再继续处理后面的输入和生成。上一轮的回答也可能在下一轮成为历史输入,进入可复用的前缀。这与网关直接保存并返回一整份旧答案的“响应缓存”不同。
这里的“开头”称为前缀。它不是几个重复关键词,而是从输入起点开始、顺序一致的一段内容。例如,两次请求都以相同的项目规则和资料开头,只在末尾追加新的问题,共同前缀便有机会复用。如果开头的规则被改写,后面即使再次出现同一份资料,也不应直接假定原来的整段缓存还能命中。
DeepSeek 的上下文缓存文档给出了多轮对话的例子。把它放在编程任务里,可以这样理解:第一次请求带上项目规则和一段串口接收代码,要求解释这段代码;第二次保留这些内容和上一轮回答,再追加“接收缓冲区满了以后,这段代码会怎样处理?”。
第二次请求的开头包含了上一轮已经处理过的内容。如果对应的缓存已经建立且仍然可用,这部分就可以命中缓存,服务端继续处理追加的问题,再生成新的回答。DeepSeek 默认开启这项功能。缓存复用的是前面内容的计算结果,第二个问题的答案仍然需要重新生成。
缓存并不会把这些内容从上下文窗口里删除。它们仍然参与本次任务,只是部分计算得到复用。压缩改变的是本次保留多少信息,缓存改变的是重复计算多少信息。因此,“缓存命中率很高”与“上下文快满了”完全可以同时发生。
上下文的组织怎样影响缓存
Prompt Cache 匹配的是模型服务实际收到的输入前缀。项目规则、工具定义、Skill 索引、已经加载的正文和对话历史,只要进入这个前缀,就可能参与匹配。它并不只缓存用户手写的那一句 Prompt,也不会因为一段内容叫作“系统提示词”就自动保证命中。
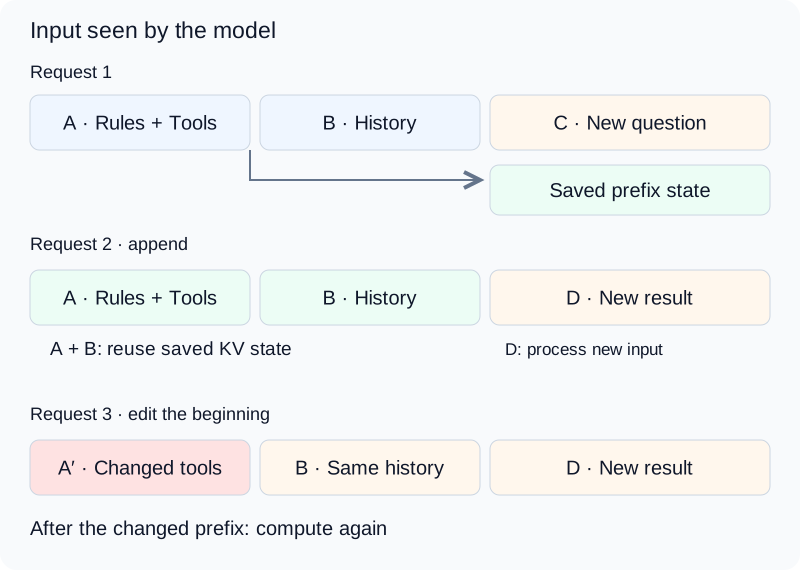
图中假设 A 和 B 对应的前缀计算状态已经保存,且当前请求满足服务的复用条件。A 是规则与工具定义,B 是保留的历史。第二次请求保留 A、B,在末尾换上新的结果 D,便有机会复用 A、B 的状态,只处理新增部分。图中的分块用于说明前缀关系,实际缓存边界由服务实现决定。
第三次请求把开头的 A 改成了 A′。即使 B 的文字完全相同,它所接续的前文也已经不同,原先整段 A、B 的计算状态便不能直接照搬。前缀中变化位置之前仍可能存在可复用部分,但变化位置及其后面的内容通常需要重新处理。这就是上下文的顺序会影响缓存的原因:同一段文字放在不同的前文之后,对应的计算状态未必相同。
对 Agent 而言,影响前缀的变化可能很具体。每轮都改写项目规则、重新排列工具定义,或者把当前时间放在最前面,都可能缩短共同前缀。启用一个新的 MCP 工具,如果改变了前部的工具列表,也可能让后面的历史失去原来的缓存。按需加载 Skill 时,如果正文只是追加在历史末尾,已有前缀较容易保持;若 Harness 把它插入开头的指令,就会改变后续内容所依赖的前文。
因此,组织上下文时,可以让长期有效的规则与工具定义保持稳定,把当前任务的新材料接在后面。稳定也包括顺序和实际内容,而不只是表达相近的意思。不过,规则确实改变、资料已经过期时,仍然要及时更新。缓存优化服务于正确的任务上下文,不能为了保留命中而继续使用错误信息。
压缩同样会影响这种结构。把一长段历史换成摘要后,摘要与原来的 Token 序列不同;保留下来的前部规则仍可能复用,替换位置之后则可能需要重建缓存。理解这点,才能把“上下文变短了”和“这次输入处理更便宜了”分别判断。
缓存的有效期与费用
缓存需要占用存储资源,不能保证一直保留。缓存的存活时间常写作 TTL(Time to Live)。DeepSeek 文档说明,不再使用的缓存通常会在数小时到数天内清理,命中也并非百分之百保证。这里给出的是服务的回收策略,不是模型能够“记住”一件事的时长。
例如,隔了一段时间再继续讨论串口代码,原来的缓存可能已经被清理。只要 Agent 仍然把那段代码和对话历史放进请求,模型就仍然可以依据这些内容回答,只是服务端需要重新计算。缓存失效和丢失聊天记录是两件事。
费用也可以沿用这个例子理解。DeepSeek 的 API 返回中,prompt_cache_hit_tokens 表示命中缓存的输入 Token 数,prompt_cache_miss_tokens 表示未命中的输入 Token 数。两者属于同一次请求的输入,生成的回答另算输出 Token。
假设第二次请求包含 21,000 个输入 Token,其中 20,000 个命中了缓存,另外 1,000 个没有命中,最终生成了 800 个输出 Token。这次调用的费用就由三部分组成:
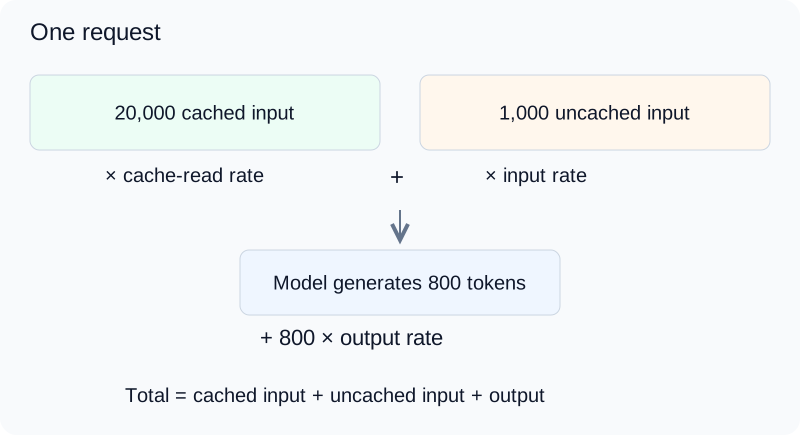
分别乘以对应单价,再相加,就是这次调用的费用。若单价按每百万 Token 标注,数量也要先除以一百万。缓存降低的是重复输入的处理费用,新问题和新答案仍然产生费用,因此缓存输入的折扣不能直接当成整个任务的折扣。
图中的绿色部分按缓存读取单价计算,橙色部分按未命中输入单价计算,生成的 800 Token 按输出单价计算。例如,仅为演示计算,假设三项单价分别为每百万 Token 0.1 元、1 元和 2 元,那么本次费用是 0.002 + 0.001 + 0.0016 = 0.0046 元。同样的输入如果完全没有命中缓存,则为 0.021 + 0.0016 = 0.0226 元。这组数字是教学假设,不是 DeepSeek 报价。
缓存读取便宜,并不意味着这些材料不再占上下文,也不意味着新答案已经存好。它减少的是重复输入对应的计算与计费。连续围绕同一份资料工作时,复用的机会通常更多;缓存被清理或公共内容发生变化后,就可能需要重新建立。有的服务还单独收取缓存写入或存储费用,实际核算以对应账单为准。Agent 产品的订阅额度如何折算,还要看产品本身的规则。
缓存优化也不等于不断增加背景材料。大量用不到的内容即使命中缓存,仍然占窗口、产生读取费用,并可能干扰判断。相反,固定规则和公共资料保持稳定,在其后追加当前任务,有利于复用。这样的组织方式既方便协作,也减少重复处理。
压缩则可能改变原来的前缀,让下一次请求需要重新建立部分缓存。因此,不能只凭“Token 数变少了”判断一次压缩一定省钱,还需要考虑整理本身、缓存重建和后续调用的总成本。任务资料、速度、容量和费用在这里联系起来:清楚的项目结构减少无关读取,可靠的工程记录帮助压缩后继续工作,稳定的公共上下文又有利于缓存复用。
Agent 结对编程:工程协作为什么仍然重要
模型能够生成代码,Harness 又让它能够读取项目、执行修改和运行测试,开发者便不必亲自操作每一个步骤。这种变化让一个人有机会完成过去难以独立承担的工作,也让软件开发中的协作问题更早出现。
过去,两名开发者共同完成项目,需要理解彼此的目标、约定接口、交接背景和检查成果。现在其中一个参与者换成 Agent,这些事情仍然存在。即使项目只有一名人类开发者,也需要考虑另一个参与者依据什么作出决定。
Agent 结对编程因此可以借用软件工程中已经积累的经验。需求分析、架构设计、版本管理和 Review,都在解决协作中的具体困难。它们的作用需要放回项目理解,不能仅仅变成一组要求 Agent 执行的流程名称。
这里尤其需要区分模型能力与工程问题。某一代模型看不懂原理图、读不完大型仓库,可能随着模型迭代改善;但项目要解决什么问题、哪些功能没有必要、最终交付什么,并不会因为模型变强而自动得到答案。
把工作方法建立在“模型永远做不好某件事”上,很容易过时。更值得积累的是如何利用持续增强的能力完成工程,以及如何处理能力增强以后仍然存在的复杂度与责任。
提示词工程:避免许愿式编程
Prompt,即提示词,是交给模型的要求与指令。提示词工程关注这些要求怎样表达。在工程中,它首先承载的是开发者对问题的理解:希望交付什么,受到哪些条件限制,哪些选择已经确定,哪些还需要讨论。
自然语言让提出要求变得方便,也容易造成一种错觉:只要把希望得到的结果描述出来,剩下的一切就都属于模型的事。例如,“做一个稳定可靠的成绩管理系统”,看起来已经表达了目标,却没有定义“稳定可靠”在这个项目中具体意味着什么。
如果没有继续讨论,文件怎样保存、同名怎样处理、异常后能否恢复,都只能由 Agent 自行选择。代码可能很快生成,功能也可能看起来齐全,但这些选择并不因此符合实际需要。
这就是许愿式编程的问题。开发者交出了一个愿望,却没有形成足够明确的需求,也没有建立检查结果的依据。最终接受的是模型补全出来的一套设想,而未必是原本想做的工程。
需求定义与方案 Review
避免许愿,需要把模糊的期待落实为可以讨论的工程要求。成绩工具要兼容哪些旧文件,查询是否返回全部同名记录,错误输入会不会改变已有数据,都是需求的一部分。
这些内容不必由开发者独自预先想完。Agent 可以阅读项目、发现遗漏并比较方案。结对编程的意义就在于共同推进理解,而不是等待某个人一次性写出完美的提示词。
但讨论的结果需要经过判断。模型提出增加功能,是因为确实需要,还是因为类似项目通常包含它?修改保存格式,是现有格式无法满足要求,还是只是新格式实现起来更方便?这些取舍影响产品本身,不能被埋在自动生成的代码里。
这也解释了为什么方案 Review 有价值。等几千行代码生成以后,再从实现里倒推模型作过哪些决定,成本很高。先讨论方案,可以在更容易理解的层面确认目标、接口与影响;后续 Code Review 才能进一步检查实现是否兑现了这些决定。
每个人都有表达问题的习惯。对话、简短说明、图示或已有代码,都可以传达设计意图。是否用了某一种模板,不决定需求是否清楚;能否围绕同一组目标与约束作出判断,才决定沟通是否有效。
实践经验与许愿的区别
工程中的许多判断依赖经验,不能靠一套固定方法推导出唯一答案。调试、试验和方案比较都可能帮助理解问题。一次实践的价值,在于它增加了哪些事实,解释了什么现象,以及怎样改变原来的判断。
许愿则省略了这种理解。遇到错误,只要求“继续修好”;得到新实现,只看它这一次能否运行。整个过程中,需求仍然模糊,修改的影响也没有被审视。
因此,反对许愿并不意味着排斥实践,而是不能把工程判断寄托在模型持续生成之后的偶然结果上。实践应当帮助开发者逐渐理解工程,而不是让代码越改越多,理解却始终停留在“这次好像能用了”。
嵌入式开发尤其需要这种理解。嵌入式软件运行在设备内部,负责设备的具体功能,例如读取传感器、控制电机、与其他设备通信。写入设备并在其中运行的软件通常称为固件。它的工作结果可能是一次实际的硬件动作,而不只是终端里的一行输出。
例如,“让电机按照指令转动”说明了一个目标,却没有说明设备刚上电时是否允许转动、没有收到新指令时应当保持还是停止、通信恢复后是否立即继续。这些选择决定设备的实际行为。没有定义,就只能由实现者补全;即使正常收到指令时电机确实能转,也不能说明这些选择已经符合需要。
所以,实施前需要知道大致的技术方向,明确希望得到什么、哪些行为不能接受。Agent 可以协助比较方案、补充问题,但开发者需要理解讨论得出的决定,以及这些决定最终怎样落实在代码里。功能验收检查设备是否完成了要求,代码 Review 则检查实现采用了什么方式、依赖哪些条件。只看一次演示成功,会遗漏后者。
这种要求与嵌入式的交付方式直接有关:固件进入实际设备后,修改未必还能像开发时一样方便。代码生成得再快,也不能代替现场排查、重新烧录和恢复设备所需的工作。需求和 Review 的投入,需要放在这个完整成本里理解。
软件复杂度管理:为什么需要 Less is More
需求能够讨论清楚以后,还会遇到另一个问题:Agent 提出的功能和设计,是否都值得保留。
过去,增加一个功能需要投入明显的编码时间。即使想法很多,开发成本也会迫使项目作出取舍。Agent 大幅降低了这部分成本,一句要求就可能生成一套实现,许多原本会被放弃的附加功能因此进入项目。
然而,生成之后的代码仍然需要集成、验证和维护。增加一种文件格式,就多一种需要保持正确的读写行为;增加一个配置项,就多一种可能影响运行结果的条件。实现速度提高了,这些后续工作不会同时消失。
成绩工具本来只需要读取固定格式的文件。如果因为“以后可能有用”,又加入数据库、多种导入格式和插件机制,接下来修改一个数据字段时,就需要考虑这些功能是否全部保持一致。额外功能尚未产生收益,维护成本已经出现了。
所以,代码越容易生成,越需要主动判断什么不必实现。Less is More 在这里有了具体含义:减少没有必要承担的功能与设计,让精力集中在真正需要交付的部分。
功能克制与设计克制
功能克制回答的是“是否需要做”。当前只需要按完整姓名查询,就没有理由仅因 Agent 能够完成,而同时加入模糊匹配、拼音搜索和复杂排序。将来出现真实需求时,可以重新判断。
设计克制回答的是“需要做到多复杂”。同样一个查询功能,可以直接遍历已有记录,也可以引入索引与通用查询框架。数据规模、性能要求和后续维护方式不同,合适的实现也会不同。
因此,Less is More 不能按代码行数衡量。必要的错误处理和测试会增加代码,却减少数据损坏与回归问题;大量包装层也可能让单个函数变短,却使阅读一次查询要跳转多个文件。
YAGNI(You Aren’t Gonna Need It)强调不要提前实现尚未需要的功能,KISS 强调保持设计简单。它们概括了这类工程经验。理解新增设计带来的成本以后,这些名称才有实际含义。Martin Fowler 的 YAGNI 文章进一步讨论了提前实现功能的代价。
这里没有一种公式能够自动判断所有设计。实践中逐渐形成的经验,是识别复杂度来自哪里:哪些由需求决定,哪些由当前实现方式引入,又有哪些根本没有必要承担。
DRY 为什么也需要判断
复杂度还可能来自同一条规则被维护在多个地方。例如,成绩有效范围在文件导入、手动录入和修改功能中各写了一遍。以后调整规则时,三个位置都需要修改,遗漏一处就会产生不一致。
DRY,即 Don’t Repeat Yourself,关注的就是重复维护同一份知识的问题。将这条规则集中表达,可以让不同入口使用一致的判断,也让人和 Agent 更容易找到应该修改的位置。
但两段代码看起来相似,不一定表达同一份知识。查询学生和查询课程都可能遍历数组,后续需要处理的规则却不同。为了消除循环上的重复,将它们合并为一个带许多开关的通用函数,反而会让两种变化相互影响。
因此,DRY 与保持简单之间需要权衡。抽象有价值时,它隐藏了共同的复杂性;抽象不合适时,它只是把不同问题捆在一起。tison 在《Agentic Coding 的边界》中讨论的过度抽象,正值得结合这种情况理解。
Agent 可以很快完成抽函数、拆模块等动作,但“能完成重构”与“这次重构有价值”是两个不同的判断。人仍然需要理解这些结构究竟减轻了什么负担。
上下文工程:架构也是信息的组织方式
复杂度不仅影响以后怎样维护,也影响 Agent 现在怎样理解项目。
模型每次工作依赖输入中的上下文。项目越大,模块之间的依赖越多,一次修改需要同时理解的信息也可能越多。如果查询、文件读取和显示逻辑混在一起,修改一个查询条件,就可能牵涉整个程序的数据流。
清楚的架构能够减少这种负担。读取模块负责产生统一记录,查询模块负责筛选,显示模块负责输出。接口约定明确以后,理解查询时就不必同时研究所有文件格式的解析过程。
Context Engineering,即上下文工程,在这里与软件设计联系起来。它不仅涉及向对话里放入哪些文件,也涉及项目本身能否提供清楚的代码阅读路径。目录职责、接口和依赖关系,决定了理解一项任务需要穿过多少无关内容。
项目规模与外部上下文
大型纯软件项目可能包含许多历史实现、兼容层和依赖。即使模型能够读取很长的内容,如何找到相关入口、理解影响范围,仍然会影响工作效率。通过架构控制信息之间的关系,比单纯堆叠说明更有长期价值。
典型的裸机嵌入式项目则可能小得多。MCU 通常称为微控制器或单片机,是设备中运行控制程序的芯片。裸机开发指程序直接管理硬件运行,没有操作系统替它调度任务。一个项目可能围绕一块确定的电路板、几种外设和一组明确的功能展开,不必承担大型通用软件中那么多兼容性和历史依赖。
因此,在硬件与工程上下文充分的前提下,这类仓库反而有机会被 Agent 完整阅读和理解。与 Linux、Chromium 这样的庞大工程相比,典型裸机项目需要同时掌握的代码往往少得多。嵌入式这个名称本身,并不能说明代码理解一定更难。运行 Linux 的设备、操作系统本身和小型裸机程序,也不能混成同一种情况讨论。
这里的前提是“上下文充分”。源码能说明程序操作了哪个引脚,却未必说明这个引脚在电路板上接到了什么。原理图记录器件的连接关系,芯片手册说明硬件功能及其使用条件,项目配置则决定时钟和外设怎样工作。这些资料与代码一起,才构成理解设备的依据。
例如,同样一条设置输出电平的语句,在不同电路中可能对应不同动作。只提供函数名和源码,让 Agent 猜外部连接,得到错误判断并不奇怪。提供实际连接和工作要求后,讨论才有共同的事实基础。当前模型能否准确读取某张原理图,是模型能力问题;工程是否提供了正确的原理图,是上下文组织问题。
但读懂工程以后,还有实际运行这一关。代码表达的是计划怎样操作硬件,实际设备是否按预期响应,需要观察运行结果。某个等待过程有没有拖延其他任务,某个异常是否会使设备无法继续工作,都不能仅由“仓库已经读完”得出结论。
这就把两个问题分开了:较小的代码体量可以降低理解成本,却不会自动降低稳定性要求。对这类项目,工作重点可能较早地落到实现是否可靠、开发者是否理解关键行为,以及实际测试是否充分。模型能力继续增强,可以帮助完成更多分析和操作;这些工程问题仍然需要得到回答。
工程知识需要有可靠的来源
如果项目里存在三份互相冲突的接口说明,增加上下文并没有自动增加确定性。模型还需要判断哪份有效,而维护者可能本来就没有统一结论。
工程知识的组织因此也遵循减少重复维护的思路。当前行为由实现和必要文档表达,重要约束有明确的维护位置,历史取舍则能追溯到当时的讨论。这样,人和 Agent 才能依据同一套事实继续开发。
Git 保存版本与差异;GitHub 等平台上的 Issue 记录问题,PR(Pull Request,合并请求)把实际修改与讨论、Review 联系起来。时间、状态和关联版本,使一条结论能够放回它成立的条件中理解。
这比不断生成没有时间背景的总结更有用。曾经为了兼容旧格式采用的方案,可能已经在后续版本被替换;如果只保留一句“项目使用某种格式”,就容易把历史决定误当成当前约束。
文档仍然必要,但用途需要明确。用户需要安装与使用说明,维护者需要理解设计理由和约束。机械复述源码、复制同一份任务记录,会增加另一套需要保持同步的内容。
Skill、项目规则和记忆机制也在处理这些信息问题。它们可以减少重复交代,但同样需要控制重复和过时内容。工具越丰富,越需要回到实际用途判断是否值得加入工作流。
Git 与 GitHub:把修改组织成可审查的工作
为什么需要版本管理
一个程序刚开始可能只有几个文件,修改以后直接保存,看起来已经足够。但随着项目继续推进,很快就会遇到这样的情况:昨天还能正常接收数据,今天改了几处代码以后却开始丢帧;旧功能还要使用,新功能又需要继续开发;两个人修改了同一个文件,合并时不知道哪些内容应当保留。
把文件夹复制成“旧版”“新版”“最终版”,可以暂时留下副本,却很难说明两版之间究竟改了什么、为什么改,以及哪一版经过了验证。Agent 一次修改多个文件时,这个问题更明显:如果只看最后的运行结果,很容易忽略顺带发生的变化。
版本管理就是把项目的变化记录下来,使这些问题有据可查。Git 是一种版本管理工具,它将选定时刻的项目状态保存为提交(Commit)。每次提交都有标识、说明和前后关联,可以查出两个版本之间的差异,也能取回某个已记录版本的文件。保存这些历史的地方,称为仓库(Repository)。
例如,串口驱动已经通过一轮验证,可以将对应代码、测试和配置记录为一次提交。随后增加功能时,如果出现故障,就能比较新旧版本,缩小排查范围;需要恢复时,也有明确的参考。Git 不会判断某个版本是否正确,测试结果和提交说明仍然需要如实记录,但它让“之前那个能用的版本”变成了能够准确找到的对象。
还没有准备接受的修改,可以先在分支(Branch)中推进。分支让一条开发路径有自己的名称,便于保留稳定版本,同时继续另一项工作。完成后再检查差异、验证结果,并通过合并(Merge)把修改纳入共同版本。这样,一项修改从开始到被接受,就有了清楚的边界。
GitHub 则是托管 Git 仓库并提供协作功能的平台。把本地提交推送上去,其他人便能取得这些版本;Issue 用来记录问题和需求,PR(Pull Request,合并请求)用来提出一组修改,集中讨论、审查并决定是否合并。Git 可以在本地使用,GitHub 将这些版本与团队的协作过程联系起来。
因此,使用版本管理的理由很具体:修改前后能够比较,故障发生后能够追溯,多项工作能够分别推进,接受和发布的结果能够对应到确定版本。接下来需要约定的,是一次提交包含什么、修改在哪条分支进行,以及什么条件下允许合并。这些约定共同构成工作流。
常用操作在流程中的位置
Git 命令提供了一套通用的操作名称,便于理解不同工具正在做什么。实际工作中,许多操作可以交给 Agent 执行,也可以通过编辑器或图形客户端完成。学习这些命令,重点是知道何时使用、会改变什么状态,以及怎样检查结果;具体参数可以在需要时查阅。
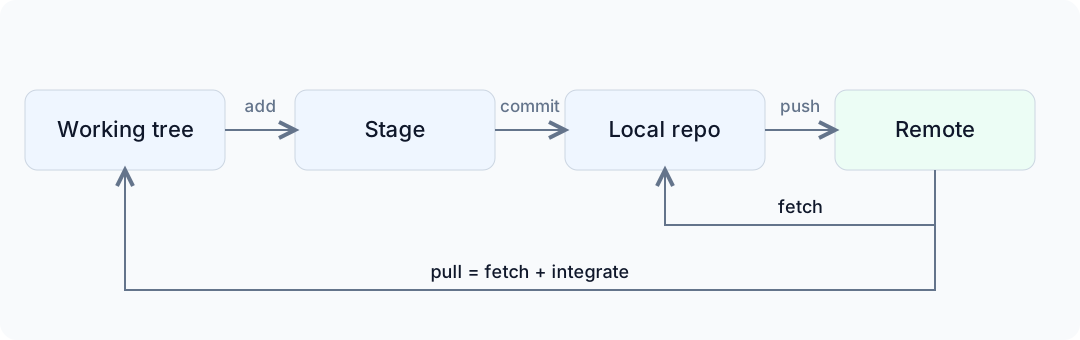
在本地,正在编辑的文件属于工作区。准备记录一项修改时,先检查差异(Diff),再把本次需要包含的内容放进暂存区(Staging Area),最后填写说明并提交。暂存区相当于下一次提交的待选内容,便于将相关修改放在一起。保存文件不会自动产生提交,Commit 也不会自动上传到 GitHub。
| 目的 | 常用 Git 命令 | 工作时关注什么 |
|---|---|---|
| 取得项目 | git clone | 将远程仓库取到本地,确认来源与当前分支 |
| 检查修改 | git status、git diff | 修改范围,以及是否混入无关内容 |
| 开始一项任务 | git switch -c | 从约定的基础版本创建工作分支 |
| 组织并保存版本 | git add、git commit | 暂存内容是否构成一项完整修改 |
| 取得远程进展 | git fetch、git pull | Fetch 获取远程记录,Pull 还会将进展整合到当前分支 |
| 共享本地提交 | git push | 将准备共享的提交上传到远程仓库 |
| 合并开发成果 | git merge | 双方修改是否经过审查和验证;团队协作中通常通过 PR 接受修改 |
| 查看历史 | git log、git show | 查找具体提交,理解修改内容与前后关系 |
| 撤销已提交修改 | git revert | 用新的反向提交保留恢复记录 |
| 标记发布 | git tag | 为确定提交命名,关联发布产物 |
例如,可以让 Agent 检查当前修改、只暂存串口修复相关的文件,再准备提交说明。执行 add 和 commit 的步骤可以委托,但仍要能判断它是否混入了另一项功能。Agent 报告“已提交”时,也需要知道这只是本地版本已经记录,并不等于已经 Push、通过 PR 或完成发布。理解这些边界,才能准确安排工作和接受结果。
具体安装、命令参数和冲突操作,可以查阅 Pro Git 的 Git 基础与分支章节。日常工作更需要养成一个顺序:先看状态与差异,再决定暂存、提交或合并。Agent 生成了总结,也仍然要检查实际 Diff。
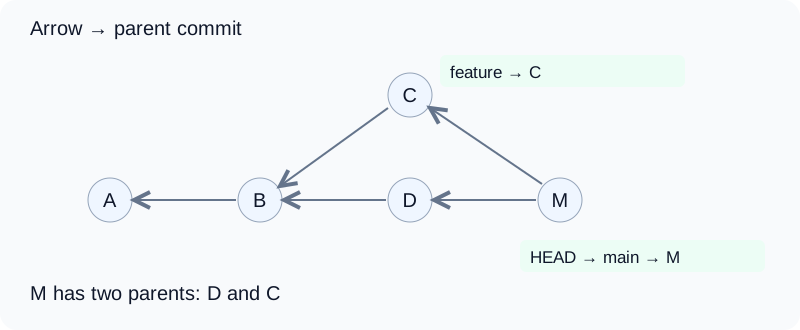
Git Graph 用圆点表示提交,用连线表示父子关系。图中箭头指向父提交,M 连接 D 和 C 两条历史。分支名称是指向提交的引用,HEAD -> main 表示当前正在使用 main 分支。读图时先找当前位置,再看目标分支和共同祖先,便能判断两边是单纯落后,还是各自增加了修改。线条颜色只是界面的辅助表达,未提交编辑则需要另看更改列表,或在终端使用 git status。
Commit Message:让历史能够被理解
一条提交应围绕一个明确目的组织,包含完成这个目的所需的代码、测试和说明。例如,修复串口解析越界时,把对应回归测试一起提交,后续就能够理解并验证这次修复;若同时混入全项目格式化和另一项功能,审查、定位与撤销都会更困难。
提交说明也需要一致的约定。Angular 的提交约定影响了今天常用的 Conventional Commits,规范名称是 Conventional Commits。它为提交说明提供结构,使人和自动化工具都能识别修改意图:
<type>[可选的 scope][可选的 !]: <简短说明>

可选正文

可选页脚
type 表示修改类型,scope 表示涉及的模块。常见的 feat 用于新增功能,fix 用于修复问题;项目还可以约定 docs、test、refactor、ci 等类型。标题写清具体变化,避免只有“update”“修改完成”这样的描述:
fix(uart): reject frames with invalid lengths
feat(query): return all records with the same name
test(parser): cover incomplete frames
ci: build firmware on pull requests
正文用于说明标题放不下的原因与约束。例如,为什么必须保留旧协议,某种更简单的修复为何不可行。关联问题可以使用 Refs: #42。涉及不兼容变更时,用 ! 或 BREAKING CHANGE: 明确标记,并说明调用方需要怎样迁移:
feat(protocol)!: add a length field to frames

BREAKING CHANGE: receivers must parse the new length field.
这种规范的价值在于让历史可读,并为发布说明和版本工具提供依据。加上 fix: 并不能弥补含糊的描述,规范也不会自行发布版本。若项目采用 Squash 合并,还应检查最终合入的那条提交说明;采用保留提交的方式,则需要整理分支内的提交。合并方式与消息规范应配套约定。
Gitflow:分支为什么需要分工
Gitflow 是 Vincent Driessen 在 2010 年提出的一种分支工作流。它通过分支职责区分日常开发、发布准备和紧急修复,适合讨论具有明确版本交付阶段的项目。
| 分支 | 职责与流向 |
|---|---|
main | 保存正式发布的历史,并用 Tag 标记版本 |
develop | 集成下一版本的开发成果 |
feature/* | 从 develop 开始,完成单项工作后合回 develop |
release/* | 从 develop 切出,稳定待发布版本;完成后合入 main,并将修复带回 develop |
hotfix/* | 从已发布的 main 修复紧急问题,再将修复带回开发线;存在发布分支时也要同步处理 |
例如,下一版本正在增加功能,但当前发布的固件发现通信故障。如果直接把开发中的所有代码一并发布,就把尚未完成验证的功能带进了修复。Gitflow 用不同分支保留这两条工作的边界:修复基于已发布版本完成,随后再同步回后续开发,避免下一版本重新出现同一个问题。
对于固件交付,还应记录 Tag、目标硬件、编译配置和测试结果之间的对应关系。仅有一个名叫“最终版”的二进制文件,很难确认它来自哪次修改,也无法可靠重建。
Gitflow 的分支数量有维护成本。作者在 2020 年的补充说明中也建议,持续交付的项目可以选择更简单的流程。小型课程项目可以采用 GitHub Flow:围绕主分支创建短期工作分支,通过 PR 检查和合并。需要固定发布阶段或并行维护版本时,再考虑 Gitflow 及相应维护分支。最佳实践的重点是让开发与交付边界清晰,而不是分支越多越规范。
Issue、PR 和 CI/CD 怎样连起来
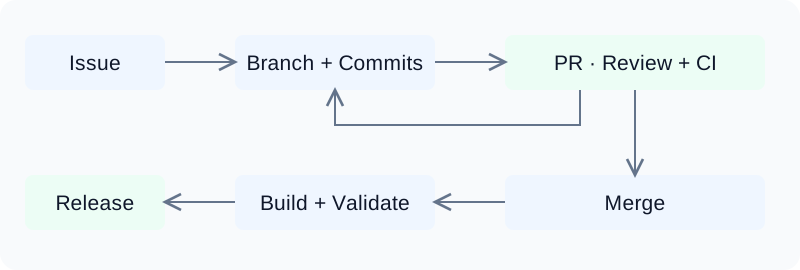
分支解决修改在哪里推进,Issue 和 PR 则保存为什么修改、怎样接受修改。以修复串口丢帧为例,可以先用 Issue 记录故障现象、硬件与软件版本、复现条件和预期行为,再讨论方案。这样,人和 Agent 都能找到同一份任务依据。
接下来从约定的基础分支建立工作分支,围绕该问题修改、测试并提交。在 Gitflow 中,普通开发通常面向 develop;采用简化流程时,通常面向 main。Push 之后创建 PR,说明解决了什么问题、修改范围、已完成的验证,以及尚待上板确认的事项,并关联 Issue。GitHub 支持用 Closes #42 等关键词关联关闭,但自动关闭还取决于 PR 是否合入默认分支;合入非默认的 develop 时,需要按团队流程管理 Issue 状态。
PR 更新后,GitHub Actions 可以自动执行 CI,即持续集成检查,包括编译、测试和静态检查。Actions 是运行这些步骤的工具,配置保存在 .github/workflows/;PR 是集中查看修改、讨论和检查结果的入口。配置方式可查 GitHub Actions 文档。
自动检查与人工 Review 一起决定修改是否可以接受。检查回答已定义的测试是否通过,Review 还要判断实现与需求是否一致、是否引入不必要的复杂度。仓库可以通过分支保护或规则集,将指定检查和审查设为合并条件。仅仅启用 Actions,并不会自动禁止合并失败的修改。
合并之后,CD 继续处理交付:持续交付把代码制作成可发布的产物,持续部署则进一步自动部署到运行环境。嵌入式项目可以自动构建并保存固件、版本信息和验证报告,但烧录到设备还需要考虑目标硬件、发布批准和失败恢复。云端编译通过,不能替代实物测试。
这条流程把需求、版本和验证连在了一起:Issue 保存问题,分支承载实现,Commit 记录修改,PR 组织审查,CI 提供重复验证,发布记录关联最终产物。对 Agent 结对编程而言,模型生成代码只是其中一步。任务完成的依据,应当是这组记录能够说明修改为何成立、如何验证,以及最终接受了哪个版本。
交付边界:工程责任怎样落实
上下文充分、结构清楚,可以改善协作,但最终仍然要回答一个问题:生成的结果凭什么可以交付。
Agent 能够执行工作,却不会替开发者承担产品责任。代码是谁敲出的,不能改变交付者需要兑现的承诺。因此,讨论是否 Review、理解到什么深度之前,首先需要确定交付对象。
应用、SDK 与 API 的不同承诺
交付一个成绩查询应用,使用者关心能否完成查询、数据是否正确、出现错误时能否继续使用。内部采用数组还是索引,可以由实现决定,但不能破坏这些行为。
如果交付的是一个供其他开发者使用的库或 SDK,情况就不同了。SDK 是软件开发工具包,可能包含库、接口和配套工具。其他程序会直接依赖它的函数、数据结构和错误处理方式,代码层面的设计本身就进入了交付边界。
例如,返回的记录由谁释放、没有结果时怎样表示、升级后原来的调用是否仍然有效,都属于需要承担的接口承诺。对这类产品,关注代码与接口并非个人偏好,而是交付形式决定的工作。
因此,人对代码负责,不等于所有代码都以相同强度逐字阅读。内部实现如果有充分的行为验证,可以减少不必要的逐行检查;处在交付边界上的接口、重要行为和设计取舍,则需要更直接的理解与 Review。
交付边界也不能只按文件位置划分。内部的文件覆盖逻辑一旦出错,可能损坏使用者的数据,它同样影响承诺。需要审查多深,取决于这些实现对交付结果的影响,以及已有验证能够提供多少依据。
嵌入式交付为什么尤其需要审慎
前面讨论过,典型裸机项目的代码体量可能并不大。Agent 能读完仓库,开发者也能掌握主要流程,但这些便利不能直接转化为“出问题以后再修就行”。嵌入式交付还受到设备所在位置、连接条件和当前运行状态的限制。
开发时,电路板就在桌上,可以连接电脑,把编译得到的固件写入设备,这个过程通常称为烧录。程序出错后,开发者可以重新烧录、复位,再观察结果。产品交付以后,设备可能已经安装到现场,无法随时接到开发者的电脑上。此时,一次修复除了修改代码,还需要解决修复版本怎样进入设备的问题。
联网设备可以采用 OTA 更新。OTA 是 Over-the-Air,指通过无线网络等通信通道远程更新设备中的软件。设备取得新固件,将它写入存储器,再按设计启动新版本。它减少了现场连接和烧录的需要,但这条更新路径本身也依赖软件和硬件正常工作。
以依赖应用程序联网下载固件的设备为例,要接收修复版本,设备首先得能够联网;而联网功能恰好由当前固件中的代码实现。如果新版本破坏了联网功能,就可能出现一个循环:修复联网需要更新固件,更新固件又需要先联网。服务器上即使已经准备好正确版本,设备也未必拿得到。
Bootloader 可以参与解决这类问题。它是一段在启动应用程序之前运行的引导程序,可以按设计选择启动哪个固件,或者进入更新与恢复流程。将部分恢复职责放在这里,有机会在应用程序出错时保留另一条处理路径。但恢复依赖什么条件、怎样触发、哪些故障能够处理,都需要在工程中落实。仅仅提到“支持 OTA”或“有 Bootloader”,还不能说明更新失败后一定可以恢复。
这也是固件回退与 Git 回退的区别。Git 可以找回旧代码,却不会自动把旧固件重新装到现场设备里。如果设备已经无法接收远程更新,仍然可能需要现场人员介入。版本保存在仓库里,和设备实际恢复到那个版本,是两件需要分别完成的事。
对于部署环境可控、能够快速替换版本的在线服务,出现问题后回滚可能比较直接。把这种开发节奏照搬到固件上,却可能低估恢复成本。设备越难接近,更新越依赖当前固件正常工作,就越需要在交付前投入充分测试和人工 Review。
因此,嵌入式开发不能只验收“功能已经做出来”。开发者还需要理解代码怎样实现功能,尤其是哪些条件一旦不成立,就会影响设备持续运行或后续恢复。需求定义要说明预期行为,方案 Review 要确认实现方向,代码 Review 要检查这些决定是否真正落地。它们共同决定是否有依据接受这个版本,而不是等设备交付以后,再用实际故障补齐理解。
Code Review:功能之外,还需要验收代码
Code Review(代码审查)是对实现及其修改进行检查,判断它们是否符合需求、是否适合进入项目。前面的 PR 提供了审查入口;真正需要完成的工作,是理解准备接受的代码,并为接受它找到依据。
发布方式决定了修复问题的代价
普通桌面应用发布新版本后,用户通常可以点击更新,或者重新下载安装。安装与文件替换有操作系统和安装程序提供支持,即使应用本身出错,也往往还可以借助这些独立于应用的工具修复。对于部署环境可控的 Web 应用,开发者可以在服务器上部署新版本,让后续访问使用更新后的程序。以不涉及数据迁移的静态页面为例,替换服务器上的文件就能完成发布。
嵌入式设备的更新条件不同。设备已经安装到现场,无法随时接线烧录时,远程更新通常要依靠 OTA。固件下载只是其中一步,还需要保证通信可用、更新包完整、存储写入正确,以及设备能够启动新版本。下载中断、写入时断电、新版本无法启动,都需要更新流程作出相应处理。用户看到的也许只是一个更新按钮,设备背后却必须先具备整条可靠的更新链路。
更关键的是,这条链路可能依赖正在被修改的固件。普通应用出错后,可以由仍然正常工作的操作系统重新安装;如果固件把设备自己的联网能力破坏了,修复版本就可能根本无法送达。前面讨论的 Bootloader、恢复入口和回退机制,正是为了处理这些问题,但它们也需要设计、实现和验证。没有远程更新条件的设备,则可能只能依靠现场操作。
因此,同样是一处代码错误,修复成本可能完全不同。Web 页面出错后可以重新部署,现场设备失联后却可能需要人员携带工具到场。Git 中保留旧版本,并不能省去把它重新写入设备的工作。嵌入式开发需要在发布前投入更多质量保障,原因就在这里:交付以后,发现问题、送达修复和恢复运行都可能更困难。Review 的投入应当与这部分代价一起计算。
工作在哪一层,就需要审查到哪一层
关于 AI 编程,一种“不必阅读生成代码”的观点常借用编译器作类比。早期开发更依赖手写汇编;高级语言和编译器普及以后,应用开发者通常阅读源代码,不必逐条检查编译生成的机器指令。既然编译器可以承担这一层转换,Agent 是否也能承担自然语言需求到代码的转换,让开发者主要关注功能?
这个类比指出了抽象工具的价值,但省略了一个条件:开发者究竟在解决哪一层的问题。一般业务开发可以把大量指令层面的工作交给编译器;需要处理指令效率、硬件行为或底层性能问题时,就仍然需要进入相应的实现层面。工具能够代劳,并不意味着那一层的代码失去了审查价值。
FFmpeg 就是一个具体例子。音视频处理中的一些函数调用频繁、计算量大,属于性能热点。为了提高这些部分的执行效率,FFmpeg 包含针对 x86 等平台的手写汇编优化。FFmpeg 开发文档也介绍了性能关键代码中的汇编使用。对使用 FFmpeg 播放视频的应用开发者,逐条阅读这些汇编通常不是当前任务;对负责优化这些函数的开发者,指令的正确性与性能就是工作本身,审查自然需要深入到这一层。
同样,嵌入式开发直接与硬件打交道。代码不仅要算出正确结果,还要在规定的时间内响应外设、安排中断与主程序的工作,并正确处理设备状态变化。这些行为取决于具体实现。界面显示“连接成功”,并不能说明等待连接时是否阻塞了控制任务;一次收发成功,也不能说明接收缓冲区在连续数据到来时仍然安全。
例如,Agent 为通信中断加入了一段“等待重新连接”的代码。审查需要进一步确认:等待有没有结束条件,等待期间采样和控制是否继续执行,恢复联网的逻辑有没有被这段等待一起阻塞。这些问题需要阅读代码、理解调用关系,再结合设备运行验证。只验收“能够重连”这个功能名称,无法回答它们。
因此,Code Review 做到什么程度,取决于开发者工作的层面,以及这一层需要兑现的行为。对嵌入式开发而言,硬件相关的执行流程、时序和异常恢复就在工作范围内,需要深入理解和审查;对性能优化任务而言,必要时还要继续检查编译结果和汇编。审查深度应当跟着问题走。
发布方式和工作层面在这里汇合:固件更接近硬件,实现细节直接影响设备行为;设备交付后,修复又受到更新链路的限制。这就是嵌入式开发需要更深入 Review 的理由。Agent 可以承担编码,但接受其产出仍然包括两件事:确认功能符合要求,确认代码以能够接受的方式实现了这些功能。
Review Diff:先确认这次到底改了什么
开源项目中的贡献要求,也可以帮助理解代码验收的边界。Pi 的 CONTRIBUTING 文档允许使用 AI 编写代码,但要求提交者理解自己的修改,能够解释它做了什么、怎样与系统其他部分相互作用。无法说明这些内容的 PR 会被关闭。
这项要求把责任落实到了提交者身上。生成代码以后,仍然需要检查修改,并把它放回整个项目中理解。否则,提交者节省的时间就可能变成维护者重新分析需求、追踪影响和排查问题的工作。Review Diff 正是开展这项检查的一个入口。
Diff 是两个版本之间的差异。它把本次新增、删除和修改的内容集中显示出来,使审查可以围绕一个具体任务展开。前面用 Issue 说明问题、用 PR 汇集修改,到了这里,就可以对照原来的需求检查:这次修改是否解决了约定的问题,又是否改变了其他行为。
编辑器通常支持并排查看 Diff:左侧是旧版本,右侧是修改后的版本,删除的行标红,新增的行标绿。另一种形式是把两侧合在同一列,用 - 与 + 标出删除和新增。行号帮助定位代码,没有变化的相邻行则提供阅读所需的上下文。
图中,connected() 表示连接状态,millis() 提供毫秒计时。右侧增加了等待满一秒后返回失败的逻辑。Diff 能清楚显示“增加了超时”,但还不能据此认定修改正确:等待期间是否妨碍其他任务,调用方是否处理了 false,都需要回到完整代码中检查。
例如,任务只是修复通信中断后的恢复逻辑,Diff 却同时改动了采样周期、缓冲区大小和公共接口。这些改动未必错误,但需要说明它们与任务的关系。否则,即使重连功能正常,也难以判断其他部分受到了什么影响。Agent 的完成说明可以帮助定位重点,实际接受的内容仍然要以 Diff 为依据。
Diff 又只展示变化,不能代替完整代码。新增的一行等待语句可能看起来没有问题,放回调用它的主循环后,才会发现它阻塞了其他任务。因此,审查要沿着差异回到相关函数、调用位置和状态变化中,理解修改对原有流程的影响。没有改变的代码,也可能因为调用方式改变而表现不同。
Git 为这项工作提供了直接入口:git diff 查看尚未暂存的修改,git diff --staged 查看准备提交的修改,git show <commit> 查看某次提交;GitHub PR 的 Files changed 页面则集中展示分支准备合入的差异。命令、编辑器和网页只是不同入口,目的都是让被接受的修改范围清楚可见。
Review 实现与功能:把代码中的判断带到设备上验证
读懂实现以后,才能更有针对性地验证功能。仍以通信恢复为例,如果代码声称断开连接后会超时退出、继续执行其他任务,并在连接恢复后重新接收数据,测试就应当实际覆盖这些行为。只检查“连接成功时能够收发”,没有检验这次修改最重要的部分。
代码审查与运行验证因而需要相互补充。阅读代码可以发现某条异常路径没有出口,设备测试可以观察超时设置是否合适、恢复后是否仍然工作正常。如果运行结果与预期不一致,还需要回到代码中查明原因,不能把一次偶然成功当作问题已经解决。
Agent 可以协助解释 Diff、追踪调用关系、寻找遗漏,并执行具备条件的测试。这些辅助工作的价值,在于帮助开发者形成接受或拒绝修改的依据。只得到一句“Review 通过”,却不知道检查了哪些代码、验证了哪些行为,仍然没有完成对实现的理解。
测试本身也需要审查。假如需求要求同名记录全部返回,而实现和测试都只处理第一条记录,测试通过仍然没有回答真实问题。尤其在 Agent 同时编写实现与测试时,需要把测试中的预期结果重新与需求对照,而不能让现有代码反过来定义什么才算正确。
同样,增加很多测试并不自动提高质量。测试应当约束需要保持的行为,而不是把内部实现再抄一遍。调整内部结构就必须同步重写的大量测试,可能只增加维护负担。把预期行为先明确下来,再据此实现和验证,就引出了测试驱动开发。
AI 工具应当帮助维护者
Linux 内核开发同样面对这个问题。内核中的驱动、内存管理和调度等工作直接涉及硬件与底层运行条件,与嵌入式开发有许多交叉。这里使用 AI 的价值,也需要放在实际开发和维护工作中判断。
在 2026 年 7 月关于将 AI 审查工具接入补丁工作流的邮件讨论中,Linus Torvalds 明确支持把 AI 作为工具使用,同时指出维护者可能因此承担额外工作。他强调,应当让这些工具帮助维护者。接受新工具和要求贡献质量,在这个立场里是同时成立的。邮件原文:Re: Linking Patchwork with Sashiko?
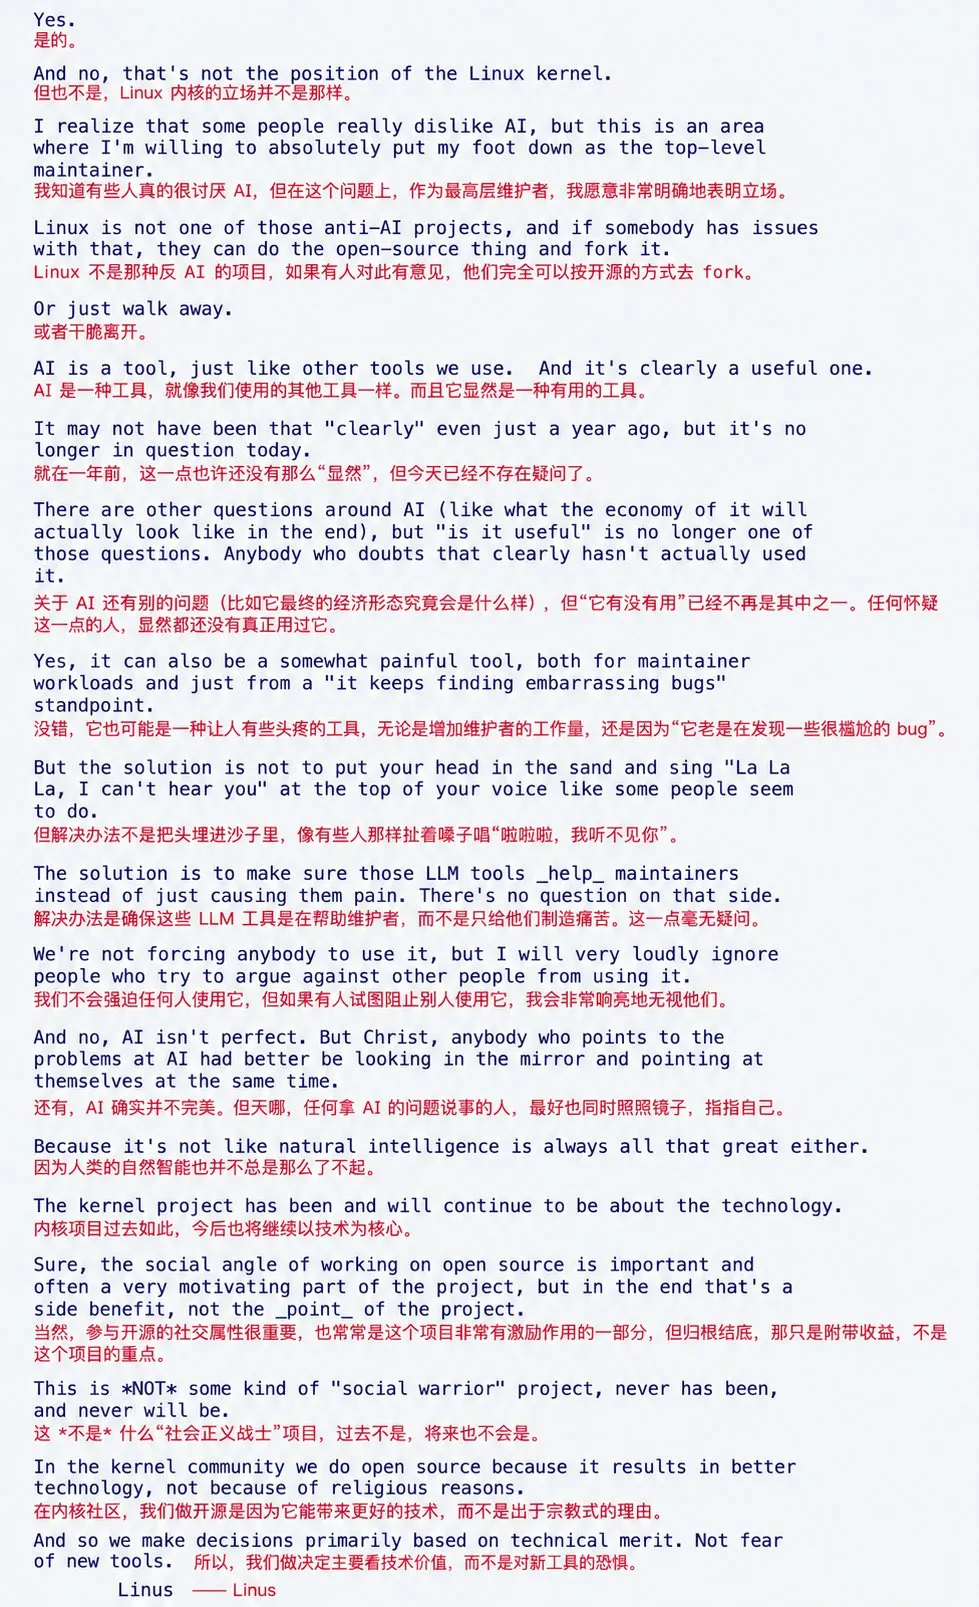
Linus Torvalds,linux-media 邮件列表,2026 年 7 月;图中中文为附加译文。
这与 Pi 的贡献要求可以放在一起理解:使用 AI 完成实现,需要同时承担理解、检查和解释修改的工作。对于嵌入式开发,前面讨论的硬件约束与发布成本,又进一步决定了这些检查需要深入到什么程度。
TDD:先把需求写成能够运行的测试
代码生成得越快,越需要及时判断生成结果是否符合要求。只在实现完成后让 Agent 补测试,容易得到一组顺着现有代码写出的检查:代码遗漏了一个情况,测试也跟着遗漏。TDD(Test-Driven Development,测试驱动开发)把这个顺序调整为先明确预期行为、写出测试,再让实现满足它。
以“同名记录应当全部返回”为例,测试数据可以包含两条同名记录和一条其他姓名的记录。查询同名姓名时,预期结果必须包含两条记录,而不是只检查“结果不为空”。这个预期来自需求,即使实现还没写出来,也已经能够确定。
先运行这条测试。原来的代码如果找到第一条就返回,测试应当失败。这个阶段通常称为 Red。失败必须对应准备解决的问题;若只是测试文件没有找到、编译环境没有配置好,就还没有证明测试能发现漏查。
随后修改查询逻辑,让同一条测试通过,这个阶段称为 Green。实现满足当前行为以后,再整理重复代码、调整函数划分,并继续运行测试,确认行为保持不变,这就是 Refactor。Red、Green、Refactor 构成一个短循环,每次围绕一项明确的行为推进。
在 Agent 结对编程中,可以先围绕需求审查测试数据和预期结果,再让 Agent 完成实现。出现失败时,应当根据失败原因修改代码;如果测试本身确实写错了,也需要回到需求解释为什么调整预期。仅仅为了让检查变绿而删除断言、放宽条件,会把原来已经明确的要求一起删掉。
修复 Bug 时,这个过程尤其直接:先把故障条件保存成能够稳定复现的测试,确认旧实现会失败,再完成修复。测试随后保留在项目里,检查后续修改是否重新引入同样的问题。这类检查称为回归测试。前面的 GitHub Actions 可以在每次 PR 更新时重复运行它,使一次修复不只停留在当时的验证结果里。
嵌入式任务怎样应用测试驱动开发
嵌入式代码中,通信协议解析、数据换算和状态转换等逻辑,往往可以先在电脑上测试。例如,解析一帧串口数据时,先定义完整数据帧应得到什么结果、数据不完整时怎样等待、校验错误时怎样拒绝,再用这些输入约束实现。测试可以先给解析函数提供一段字节数组,不必等串口硬件连接完成才检查解析规则。
这也会影响代码组织。若解析过程直接混在读取串口寄存器的代码里,测试就难以单独提供输入。把接收数据与解析数据分开,既便于测试,也让硬件相关的部分更容易辨认。这样的拆分有具体目的:能够独立检查协议行为。
电脑上的测试通过以后,还要把解析逻辑接到实际接收流程中。真实设备可能出现分批到达、缓冲区溢出、通信中断或恢复后残留旧数据等情况。TDD 帮助提前落实可描述的行为,硬件测试继续检查这些行为在实际运行条件下是否成立。
工程实践需要根据问题选择验证方式。桌面工具可以直接检查文件和输出,固件则需要把程序行为与实际设备联系起来。例如,通信数据的解析可以用预先准备的数据检查;真正连接外设后能否稳定接收,还要观察设备上的运行结果。前一种检查能帮助定位代码逻辑,后一种检查才能补上真实连接与运行条件。
时间也是行为的一部分。程序最后算出了正确结果,却错过了设备需要这个结果的时刻,仍然可能不符合要求。中断是硬件事件使处理器暂时转去执行相应处理代码的机制,外设则可能在主程序运行期间持续产生事件。一次正常演示只经历了其中一部分运行情况,不能据此推断其他事件组合也能正确处理。
这正是 Review 与实际测试各自有用的原因。阅读代码可以检查某段等待在什么条件下结束、异常后会进入哪条路径;运行设备可以观察这些路径在实际条件下是否符合预期。Agent 可以辅助分析日志、比较修改,也可以借助合适的工具参与测试,但接受结果的人仍然需要知道测试检查了什么,还有哪些行为没有得到确认。
这些差异决定了工作流不能只有一种。重要的是需求、方案、实现和交付之间存在可理解的联系。开发者能够解释为什么接受这个结果,而不是仅仅相信模型报告“已经完成”。
经典软件工程经验为何仍然有效
前面的复杂度、上下文和交付问题,并非 AI 出现后才存在。Agent 改变了代码的生产方式,却仍然参与同一个需要协作、维护和交付的软件工程。
《人月神话》讨论进度、协作与系统设计,《代码整洁之道》讨论代码组织与可读性。它们解决的问题与模型如何更快生成代码并不相同,所以新模型出现,并不会自然淘汰这些经验。
多 Agent 协作就是一个例子。增加一个 Agent 很快,但每个参与者仍然需要背景,需要与其他模块保持一致,结果也需要整合与核查。三个 Agent 分别采用三种文件格式,各自完成任务之后,项目仍然无法组合使用。
《人月神话》对任务可分割性和协调成本的讨论,因此有了新的应用场景。能否并行取决于工作之间的关系,不能直接从 Agent 数量推导完成速度。《Agent 时代的人月神话》适合与原书对照阅读,观察这些问题在新工具下怎样出现。
经典也需要结合条件理解。清楚的命名有助于阅读,但把完整逻辑切成大量短函数,未必让项目更清楚;减少重复知识有价值,过早合并不同职责却可能增加耦合。
因此,学习的对象是问题、理由与取舍。具体做法会随着语言和工具变化,有些旧方法可以淘汰,有些长期问题仍然值得研究。经典的价值并不要求每条建议都原样执行。
Piglei 的《AI 编程是一种“框架”》讨论了便利背后的控制权与认知成本;《一份关于 AI 编程的简明行为指南》则讨论协作、验证和责任。它们适合与这些工程问题放在一起阅读,理解不同实践者作出建议的背景。
持续学习:模型、工具与经验都在变化
经典经验帮助理解长期问题,模型与工具的具体能力则需要持续更新认识。过去难以完成的任务,可能在新版本中变得容易;过去必要的提示词和辅助流程,也可能被产品内置能力替代。
因此,Agent 结对编程没有一套可以学完后永久沿用的配置。模型、Harness、工具接口和项目条件都会变化。积极使用新技术,也包括重新检查原来的工作方法是否还有必要。
这种变化并不要求每天推翻全部经验。需要区分的是:一条判断建立在某个模型版本的限制上,还是来自工程本身的约束。前者需要随能力更新,后者则需要结合具体需求继续处理。
模型发布信息怎样联系实际能力
前面介绍的参数、Token、上下文和工具调用,能够帮助理解厂商的发布信息。发布文章描述新增能力,技术报告解释训练和评测,模型卡片则说明可使用的规格。
千问提供了一个直观例子。同一品牌下可以有不同大小、不同结构和不同用途的模型。以 2025 年发布的 Qwen3为例,8B 表示约 80 亿参数;30B-A3B 表示总参数约 300 亿,每个 Token 激活约 30 亿。
后者采用 MoE,即混合专家结构:模型内部有多个负责计算的网络组件,每个 Token 只选用其中一部分。它们不是多个独立 Agent。激活参数影响计算量,部署时仍需考虑全部权重的存储。
参数规模描述模型体量,上下文长度描述一次可以容纳多少信息,输入与输出模态决定能处理什么形式的内容。这些信息解决不同的问题,不能合成一个简单的“越大越好”。
同一生态中还有视觉模型、语音模型,以及用于检索的 Embedding 模型。检索模型把整段文本表示为向量,用于查找含义相关的材料;生成模型则可以利用查到的材料回答问题。应用可以根据需要组合这些能力。
厂商暴露的 API、应用接入的模型和 Harness 提供的工具,共同决定最终体验。因此,更新模型与更新 Agent 应用可能改善不同环节:前者提高理解或生成能力,后者改善信息获取、执行和协作方式。
Benchmark 衡量的是特定条件下的表现
Benchmark 是一组规定好的任务与评分方式。一个测试要求补全函数,另一个要求修复仓库问题,还有的要求识别图片。它们测量的能力不同,即使都以百分比显示,也不能直接互相替代。
Agent 编程评测还包含执行系统的影响。能够搜索仓库、运行测试,并允许多轮修正的系统,与只生成一次答案的模型,取得成绩的条件不同。
pass@1 与 pass@k 等指标反映尝试次数的区别:单次能否完成,与多个候选中至少一个成功,并不是同一种使用体验。推理时间、工具配置和计算预算,也需要一起理解。
因此,发布结果可以帮助判断新能力是否值得关注,却不能替代项目中的实际观察。一次成绩查询任务与一个有多年兼容负担的软件仓库,要求并不相同。工具是否改善工作,还包括审查、返工和维护所付出的成本。
信息来源与自主学习
技术不断变化,学习也就不能只发生在上课的时候。模型更新了能力,编程工具改变了工作方式,嵌入式项目更换了芯片和开发框架,都可能要求重新理解原来的做法。持续学习首先需要解决的,是这些变化通过什么渠道进入视野。
一手信息与二手信息怎样区分
一手信息是某项事实、成果或经验的直接来源。例如,模型研发团队公布自己的实验方法和评测结果,工具开发者说明新版本改了什么,芯片厂商在手册中定义寄存器的行为,都直接记录了信息产生者所做的事情。需要了解新模型或新功能时,发布文章、原始论文和官方文档通常是很好的起点。
如果另一位作者读完这些资料,再筛选重点、解释术语并整理成教程,那么针对原始成果的这部分讲解就是二手信息。它已经经过一次理解和转述,可能更适合初学者,也可能省略了原文中的适用条件。二手并不等于错误或低质,一手也不自动保证结论完整、公正。区别首先在于信息与原始事实之间隔了几层解释。
以嵌入式开发为例,芯片手册说明某个状态位怎样清除,这是接口定义的一手资料;教程将它解释成一段容易理解的操作步骤,是对这项定义的二次讲解。如果教程作者又发现某种中断时序会触发故障,并记录自己的接线、代码和测量结果,这一部分就成为新的实践经验的一手资料。同一篇文章里,可以同时存在转述和原创。
因此,判断依据是内容的来源,而不是“官网、博客、视频”这样的形式。读懂一篇教程之后,能够找到它引用的手册或实验,便可以继续确认细节;遇到原创经验,则要关注它成立的硬件条件、软件版本和验证过程。这样取得的信息,才方便用于自己的工程。
社区经验本身也是一手资料
一手资料不等于只有官方资料。实践者记录调试过程、解释方案取舍并提出新观点,这些内容就是其经验的直接来源。博客和信息流中既有转述,也有原创,需要根据内容区分。
开源代码展示了最后留下的实现,却未必解释为什么采用它。失败过的方案、环境限制和调试中的发现,往往需要通过文章、Issue 和 PR 才能理解。阅读这些内容,可以获得单看源码难以还原的经验。
社区作者因此不仅是解释技术的“翻译官”,也可能是新观点的提出者。与不同实践者交流,能够接触到不同项目条件下的判断。它与等待传统意义上的教师逐项传授知识,是不同的学习关系。
Piglei 的两篇文章与关于 AI 编程框架的讨论发表于 2026 年 3 月和 2 月,当时 AI 编程工具已经经历了一段时间的迭代。文章记录了那个阶段形成的实践认识;后续工具继续变化,其中的能力判断也需要放回时间背景理解。
这同样适用于既有的个人经验。某种做法曾经有效,并不保证它永远值得保留;一篇新文章提出不同看法,也不意味着旧经验全部失效。真正需要比较的是项目条件、问题和理由。
持续学习为什么不必依赖固定教师
传统教学常由教师先理解材料、安排顺序,再按学习者能够接受的节奏讲解。这项工作有价值,但在快速迭代的技术领域,任何人都需要继续阅读和实践,教师也不例外。某个阶段掌握得更多,并不意味着此后始终拥有更新、更完整的答案。
如果学习只能等待固定教师准备好下一节课,信息获取就会受制于他的关注范围、更新时间和讲解安排。接触新技术时,更主动的办法是直接取得资料,再寻找理解它所需要的帮助。学习的起点可以是一份新文档、一个正在发生的故障,或一场社区讨论,不必总是一门已经编排好的课程。
AI 改变的正是取得这种帮助的成本。面对同一份资料,它可以解释术语、翻译段落、换一个例子,也可以根据已有知识重新安排讲解。在有搜索和文档读取工具的情况下,还可以帮助查找更新记录、比较不同版本。过去需要等待人类教师消化后再传授的许多工作,现在可以围绕当前问题即时完成。
对于知识转述、基础讲解和反复答疑,AI 因而可以承担传统教师的许多职责。学习者可以按自己的节奏追问,也能把实际项目带入讨论。持续学习仍然必不可少,但完成这些学习活动,不再要求始终有一位固定的人类教师陪伴。
Mentor 提供的是指导与反馈
不依赖固定教师,并不意味着不需要指导。Mentor 更接近导师:帮助辨认真正的问题、理解方案取舍,指出尚未注意到的条件,并对实践结果给出反馈。这种关系不必由一个人长期包办,也不取决于对方是否具有教师身份。
例如,通信程序能够编译,却在运行一段时间后丢数据。AI 可以帮助阅读驱动、解释缓冲区逻辑;做过同类项目的学长可能提醒检查中断占用和日志输出;社区中的维护者则可能说明某个驱动版本的已知问题。它们提供的是不同来源的指导,可以在同一项学习中互相补充。
导师因此可以是 AI、学长、同事或社区中愿意交流的人。选择取决于当前问题和能够接触的信息渠道:需要解释概念时,可以借助 AI;需要判断实物现象时,可能更需要设备测量和有相关经验的人;需要理解项目内部约定时,可以阅读维护者的讨论并向其请教。
这种导师关系也允许共同探索。面对新模型、新工具或未遇到过的硬件问题,指导者未必已经知道答案,但可以帮助找到资料、提出假设、设计验证,再根据结果修正判断。重要的是这次交流是否增进了理解,而不是把某个人固定为所有问题的答案来源。
AI 怎样参与具体的学习
直接阅读资料时,AI 可以承担许多过去依赖教师完成的工作:翻译、解释术语、补充例子,并根据已有基础调整讲解方式。遇到不理解的地方,可以继续追问,不必等待一门完整课程出现。
例如,学习者已经掌握 C 的函数,却没有接触网络 API。结合官方文档,AI 可以解释请求与返回值的对应关系,再把它联系到模型调用。原始资料提供依据,AI 帮助补齐理解所需的背景。
具备检索能力的 AI 还可以帮助定位文档、比较版本和整理相关讨论。它的价值不仅在于给出答案,也在于降低接触新技术的门槛,让学习能够围绕当前问题及时发生。
这种便利仍然需要与思考和实践结合。代码行为可以通过运行观察,接口定义可以回到文档核对,设计建议可以结合交付条件讨论。解释流畅与理解正确之间,还需要这些联系。
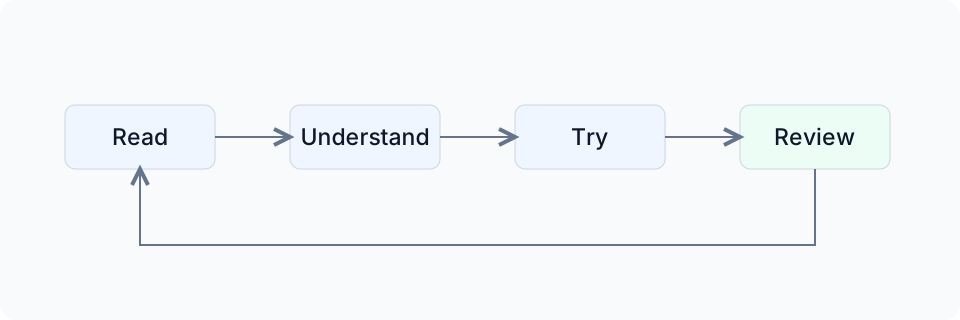
“学而不思则罔,思而不学则殆。”阅读让经验不局限于已经做过的项目,思考帮助判断别人的结论为何成立,实践则形成新的认识。AI 可以参与其中的每一环,但不能让这些环节失去联系。
建立信息渠道,而非寻找永久答案
官方资料、开源社区、个人博客和经典著作,可以共同构成学习来源。它们分别提供产品变化、实现与讨论、实践经验,以及长期问题的分析。
RSS、订阅列表和书签都可以帮助整理这些渠道,具体使用哪种工具取决于个人习惯。重要的是能够找到原始出处,知道观点形成的条件,并在工具变化时重新判断。
Tw93 的《你不知道的 Agent:原理、架构与工程实践》适合继续理解模型、工具与 Harness 的联系,“你不知道的”系列也值得持续阅读。大模型原理可以继续观看前面推荐的《大模型进化论》,工程问题则可以结合《人月神话》《代码整洁之道》和社区实践讨论。
Agent 结对编程的工作方法也将在这样的学习中变化。具体表达习惯、工具组合与协作节奏可以不同,但对项目的理解不能停留在一个愿望上:开发者需要知道正在交付什么,为什么采用当前设计,以及实际结果是否兑现了这些要求。